数据集Alpaca格式和ShareGPT格式

在我们使用和构建数据集的时候,经常会碰到两种格式的数据,分别是Alpaca格式和ShareGPT格式,今天就来介绍一下它们的共同点和不同点。

1、典型数据

首先来看一下Alpaca格式的典型数据:

[{
	"instruction": "将下面句子翻译成英语",
	"input": "我叫张三",
	"output": "My name is San Zhang"
}, {
	"instruction": "将下面句子翻译成英语",
	"input": "我叫李四",
	"output": "My name is Si Li"
}]

然后是ShareGPT格式的典型数据

[{
	"messages": [{
			"role": "user",
			"content": "3加2等于多少,只说数字"
		},
		{
			"role": "assistant",
			"content": "5"
		}
	]
}]

instruction、input、output 是 Alpaca 格式指令微调数据集的三个核心字段,用来让模型学会“看懂指令并给出对应回答”。‌‌

具体来说:

  • ‌instruction(必填)‌:告诉模型要完成什么任务,比如“列出三种交通工具”“解释什么是机器学习”。
  • ‌input(选填)‌:任务需要的辅助信息或上下文。如果指令本身已经说清楚了,这项可以留空字符串 ""。
  • ‌output(必填)‌:模型应该给出的标准回答,也就是“参考答案”。‌‌

数据一般存成 JSON 或 JSONL 文件,每行就是一条样本,例如:

json{"instruction":"列出三种交通工具。","input":"","output":"汽车、火车、飞机。"}
{"instruction":"总结下面这句话的主要观点。","input":"人工智能正在快速发展。","output":"人工智能发展迅速。"}

两种常见格式怎么选

  • ‌Alpaca 格式‌:就是 instruction/input/output,适合单轮问答、任务型指令,也是新手入门首选。
  • ‌ShareGPT 格式‌:用 conversations 列表记录多轮对话(human 和 gpt 轮流发言),适合训练聊天、客服这类多轮对话模型。‌‌

新手做数据集的小建议

‌字段必须是纯文本‌:如果 input 或 output 里出现了数组、字典这类嵌套结构,训练时会报错,需要先转成 JSON 字符串再喂给模型。‌‌

‌先跑通再扩量‌:50–100 条就够验证格式和训练流程没问题;想看到明显效果一般要 500–1000 条;3000 条以上效果才比较稳定。

‌别把知识全塞进微调‌:知识类内容适合用 RAG,微调更适合练回答格式、分析逻辑和风格。

揭开指令微调的神秘面纱

大模型指令微调作用

关于指令微调的作用描述:

  • 指令微调,在于预训练基座大模型并未针对对话或遵循指令进行优化。大模型不会回答提示:它们只是在提示后附加文本。指令微调有助于使生成的附加文本更有用。
  • 指令微调是一种专门的微调技术,通过在大量包含指令和相应响应的数据集上训练模型,使其能够更好地理解和执行用户的指令。这种方法不仅提高了模型对指令的理解能力,还增强了其生成符合预期的高质量响应的能力。
  • 通过指令微调,可以弥合LLM的下一个单词预测目标与LLM遵守人类指令的用户目标之间的差距。通过在指令数据集上微调LLM,可以使其更加符合用户需求,提高其可控性和可预测性。

我们举一个列例子,可以想象:

如果没有微调,基础大模型可能会对 “教我如何游泳” 的提示回复 “去专业的游泳馆”。

这在语法上是一种合理的完成句子的方式,但显然不能满足用户的需求,用户的初始用意应该是让大模型输出游泳的姿势动作以及如何掌控等,以帮助其学会怎么游泳。

就像之前开玩笑说会出现大量的提示语工程师(Prompt Engineer),提示语工程其实就是在做任务的微调(无参数更新),以便模型输出的结果更可能满足业务所需。

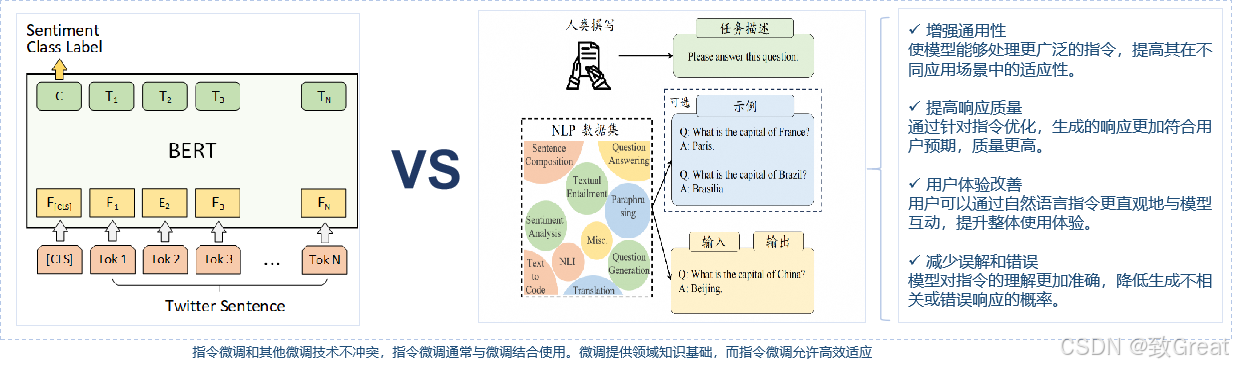
大模型指令微调与传统微调对比

指令微调通过给予模型明确的指令和反馈,为使模型专门化提供了一种替代方法,与微调只是提供输入输出示例不同,指令微调能够利用自然语言和对话,解释期望的行为和评估标准。

  • 目标不同:
    • 传统微调:通常针对特定任务(如情感分析、机器翻译)或特定领域(如医学、法律)进行优化。
    • 指令微调:旨在提升模型对各种通用指令的理解和执行能力,使其能够处理多样化的指令需求。
  • 数据类型:
    • 传统微调:使用专门针对某一任务或领域的数据集。
    • 指令微调:使用包含各种指令及其理想响应的数据集,覆盖广泛的任务和应用场景。

指令微调和其他微调技术不冲突,指令微调通常与微调结合使用。微调提供领域知识基础,而指令微调允许高效适应

指令微调需要在标记的(输入、输出)对上进行有监督学习。指令微调与其他形式的有监督微调(SFT)的区别在于:

输出展示了对这些请求的理想响应


从 GPT 这样的模型开始,大语言模型领域近年来取得了显著的进展。然而,即使这些模型变得越来越强大,它们在回答用户查询时的准确性也往往达不到预期。为了解决这个问题,人们已经开发了各种各样的策略,例如提示工程、RAG和系统提示等,这里讨论另一个重要的手段—— 指令微调。

指令数据集中的输入样本完全由类似于用户在提示中可能提出的请求的任务组成;

1. 为什么要进行指令微调?

大模型的训练方式与其在实际应用中的期望表现之间存在显著差异,这是进行指令调优的核心原因。

训练目标:LLM 通常通过预测大规模文本语料中的下一个词来学习语言模式,其核心是语言建模任务。 用户目标:用户则希望模型能够准确理解并遵循指令,以清晰、有条理且安全的方式回答问题或完成任务。

例如,如果一个模型仅被训练用于预测下一个词,当用户提问“植物是如何生长的?”时,它可能生成相关但零散的信息。而用户真正期望的是结构化、易于理解的解释。

指令调优正是为弥合这一差距而设计——使模型更好地理解和响应用户的实际需求,从而提升其实用性与可用性。

如果您对大模型的应用更感兴趣的话, 可以参考潘淳等老师的书——

2. 什么是指令微调?

指令调优是对已经预训练的大模型在特定数据集上进行进一步训练的过程,该数据集由成对的“指令—响应”组成,旨在帮助模型更好地理解并响应用户的指令。这类数据集的作用是弥合模型原本基于词汇预测的语言建模目标与用户实际使用场景之间的差距,使模型输出更贴近人类期望的内容。通常,这些指令类似于人们在真实场景中会提出的查询,例如“用简单的术语解释光合作用”,而对应的响应则是结构清晰、内容准确的回答,如“光合作用是植物将阳光转化为能量的过程”。通过这种方式,指令调优提升了模型对用户意图的理解能力。

这一方法带来了多个显著优势。首先,它提高了模型输出与用户需求之间的对齐程度,使其在面对具体问题时更加响应迅速且准确;其次,经过调优的模型在执行任务时行为更具一致性,表现出更强的可控性和可预测性;此外,指令调优还具有较高的效率,能够在不改变原有模型架构或进行大规模再训练的前提下,快速适配新的应用场景和领域需求。

然而,指令调优也面临一些挑战。高质量的指令—响应对的生成成本较高,往往需要大量人工参与以确保内容的准确性与多样性;同时,如果训练数据覆盖范围有限,模型可能只在特定任务上表现良好,难以泛化到未见过的新任务;更值得注意的是,部分模型可能仅学会了模仿响应格式等表面特征,而未能真正理解任务背后的语义逻辑,这限制了其在复杂场景中的应用潜力。

3.如何实现指令微调?

3.1 构建指令数据集

构建指令数据集是提升大模型理解和响应特定指令能力的关键步骤。这一过程主要通过两种方法实现:数据集成与合成生成。数据集成涉及将来自不同来源的带注释自然语言数据组合在一起,例如利用现有的问答数据集来创建指令-响应对。这种方法的一个实例是从已有的QA数据集中提取问题和答案,如使用“什么是重力?”作为指令,并配以相应的解释性回答:“重力是一种将物体相互吸引的力。” 这种方式不仅能够丰富指令数据集的内容,还能确保其包含广泛的主题和应用场景。

另一种方法是合成生成,即借助LLM根据少量种子数据自动生成指令及其对应的响应。比如,可以先提供一些基础指令示例,像“描述牛顿定律”,然后让模型基于这些示例生成更多类似的指令-响应对。这种方式的优势在于能够快速扩展指令数据集,同时保持一定的多样性和创新性。此外,指令还可以来源于手动收集的数据,这包括从实际应用中直接获取的真实用户查询,以及通过使用LLM从小规模种子数据开始逐步扩展而来的指令集合。无论采用哪种方法,目标都是创建一个既全面又精确反映用户需求的高质量指令数据集,为后续的指令调优奠定坚实的基础。

3.2 微调模型

在构建好高质量的指令数据集之后,下一步是对大模型进行有监督的微调。这一过程通常以指令作为输入,并训练模型逐个 token 地预测期望的输出响应,从而使其更好地理解和执行用户的请求。根据所使用的数据来源和生成方式,指令数据可分为人工创建和合成生成两大类。

人工数据通常是手工编写或从互联网中直接收集而来,虽然规模相对较小,但质量较高、针对性强,能够有效反映真实用户的需求。例如,Natural Instructions Dataset 是一个广泛使用的指令集合,涵盖了多种任务类型;P3 提供了跨语言的公共提示池,适用于多语种场景;FLAN 2021 和 LIMA 等数据集也在指令调优领域发挥了重要作用。

另一种常见的方法是通过“蒸馏”技术生成合成数据。蒸馏是一种将知识从一个强大但复杂的“教师模型”转移到更轻量、高效的“学生模型”的过程。这种方式不仅降低了数据生成的成本和时间,还能提升模型在特定任务上的表现和泛化能力。典型的合成数据集包括 AlpacaDataCleaned、WizardLM、Orca-2–13b 和 Baize 等,它们为模型训练提供了丰富且多样化的样本支持。

无论是使用人工标注还是合成生成的数据,微调的目标都是让模型更加精准地理解用户意图,并在实际应用中提供更具结构化和实用性的回应。

3.3 通过自我完善合成数据

为了进一步提升模型的指令遵循能力,可以采用一种称为自我改进的方法,这种方法利用模型自身生成的输出来逐步优化其性能。自我改进的核心在于使用模型产生的结果作为反馈机制,从而不断调整和改进模型对指令的理解与执行能力。具体来说,这一过程通常从手动创建的任务作为种子数据开始,这些任务为模型提供了初步的学习材料。接着,利用这些种子数据,模型可以通过少量样本学习的方式生成新的指令,并根据任务的具体类型(如输入优先或输出优先)来产生相应的响应。为了确保生成内容的质量,在这个过程中会应用特定的规则对输出进行筛选和过滤,以剔除不符合要求的结果。

这种自我完善的策略不仅能够帮助模型在没有大量人工干预的情况下扩展其知识库,还能有效提高指令跟随的准确性和多样性。例如,SPIN 和 Instruction Back Translation 等项目展示了如何通过自动化流程生成高质量的指令-响应对,进而增强模型的表现。此外,许多著名的指令微调大型语言模型也采用了类似的自我改进方法,包括 InstructGPT、FLAN-T5、bloomz、Claude 和 GPT-4 等。这些模型通过不断地自我学习和优化,能够在各种应用场景中提供更加精确和有用的响应,满足用户的多样化需求。这种方法的成功实施证明了自我改进技术在提升模型性能方面的巨大潜力。

如果需要本地化部署,可以参考孙杰老师的书——

3.4 多模态指令调优

随着技术的进步,指令调优正逐步扩展到涵盖多模态任务的领域,这意味着大模型现在能够同时处理文本、图像以及其他类型的数据。这种扩展不仅增强了模型的应用范围,也使得它们能够更准确地理解和响应复杂的用户需求。例如,在医疗影像分析中,模型可能需要结合病历文本和X光图像来提供诊断建议;在教育领域,模型或许要处理教材文本与相关插图以生成教学内容。为了支持这类应用,研究人员开发了多种多模态数据集,这些数据集旨在训练模型理解并处理不同形式的信息。比如,MultiInstruct多指令数据集提供了丰富的跨模态指令-响应对;PMC-VQA 和 LAMM等则专注于特定领域的多模态数据整合;Vision-FLAN等项目进一步探索了视觉信息与自然语言处理的融合。

与此同时,一系列专为多模态任务设计的模型也在不断涌现,如 instruct-pix2pix 能够根据文本指令编辑图像; Instruct-BLIP 则展示了如何将视觉元素与语言指令相结合,实现更加智能的交互体验;Otter 模型则代表了在多模态理解方面的最新进展,它能够有效地处理并生成涉及多种数据类型的复杂输出。通过这些努力,多模态指令调优正在开启人工智能应用的新篇章,推动技术向着更加智能、灵活的方向发展。这一进步不仅标志着技术上的突破,也为各行各业带来了无限的可能性。

如果您对多模态数据分析感兴趣的话, 可以参考巴川老师的书——

4.指令微调实践

在这里,尝试探讨如何在一项专注于数学领域的指令型数据集上对 GPT-3.5 Turbo 进行微调,以提升其在数学问题求解与逻辑推理方面的能力。

所使用的数据集来源于 HuggingFace 平台(~/qwedsacf/grade-school-math-instructions),该数据集专为训练模型理解和解答小学水平的数学问题而设计。它不仅包含丰富的数学题目和对应的解题步骤,还采用了结构化的组织方式,使模型能够更有效地学习从问题描述到答案推导的整个过程。这种以教程为基础的学习形式有助于增强模型在实际应用场景中的推理能力与泛化表现。

4.1 将数据转换为 JSON 格式

该数据集以 Parquet 格式提供,这是一种经过优化的列式存储格式,非常适合大规模数据的高效存储与分析处理。然而,由于 GPT 模型在进行微调时需要接收 JSON 格式的输入,以便更好地支持基于文本的任务处理,因此需要将数据转换为这一格式。JSON 结构不仅能够清晰地保留指令与响应之间的对应关系,还能提升模型训练过程中对文本数据的解析效率和准确性。

代码语言:javascript

AI代码解释

import json
import pandas as pd
from datasets import load_dataset

def prepare_math_data(dataset_name="qwedsacf/grade-school-math-instructions"):
    # Load dataset from Hugging Face
    dataset = load_dataset(dataset_name)

    # Convert to fine-tuning format
    def format_example(example):
        return {
            "messages": [
                {"role": "system", "content": "You are a helpful math tutor."},
                {"role": "user", "content": example["Instruction"]},
                {"role": "assistant", "content": example["Response"]}
            ]
        }

    # Process training data
    training_data = [format_example(item) for item in dataset["train"]]

    # Save formatted data
    with open('math_training.jsonl', 'w') as f:
        for item in training_data:
            f.write(json.dumps(item) + '\n')

    # Create validation split
    df = pd.DataFrame(training_data)
    train_df = df.sample(frac=0.8, random_state=42)
    val_df = df.drop(train_df.index)

    return train_df, val_df

def analyze_data(train_df, val_df):
    total_examples = len(train_df) + len(val_df)
    avg_instruction_len = train_df['messages'].apply(
        lambda x: len(x[1]['content'])
    ).mean()
    avg_response_len = train_df['messages'].apply(
        lambda x: len(x[2]['content'])
    ).mean()

    return {
        "total_examples": total_examples,
        "training_examples": len(train_df),
        "validation_examples": len(val_df),
        "avg_instruction_len": avg_instruction_len,
        "avg_response_len": avg_response_len
    }

4.2 微调GPT-3.5 Turbo

为了提升模型在数学相关指令上的理解与响应能力,我们采用JSON格式的数据集对其进行训练。这种格式能够更有效地组织和表达结构化信息,使模型在处理基于数学的指令时,能够准确捕捉输入与输出之间的逻辑关系,从而生成更具针对性和准确性的回应。通过这种方式,模型可以更好地掌握数学问题的求解思路,并以清晰、有条理的方式呈现答案,显著增强其在教育、辅导等应用场景中的实用性与智能化水平。

代码语言:javascript

AI代码解释

import json
import openai
from datasets import load_dataset
from typing import List, Dict
import os

def prepare_training_data(dataset_name: str = "qwedsacf/grade-school-math-instructions") -> str:
    """Prepare training data in OpenAI format"""
    dataset = load_dataset(dataset_name)

    training_data = []
    for item in dataset["train"]:
        training_example = {
            "messages": [
                {"role": "system", "content": "You are a helpful math tutor."},
                {"role": "user", "content": item["INSTRUCTION"]},
                {"role": "assistant", "content": item["RESPONSE"]}
            ]
        }
        training_data.append(training_example)

    # Save to JSONL file
    output_file = "math_training.jsonl"
    with open(output_file, "w") as f:
        for item in training_data:
            f.write(json.dumps(item) + "\n")

    return output_file

def start_finetuning(
    file_path: str,
    model: str = "gpt-3.5-turbo",
    openai_api_key: str = None
) -> str:
    """Start fine-tuning job"""
    if openai_api_key:
        openai.api_key = openai_api_key

    # Upload file
    file_upload = openai.files.create(
        file=open(file_path, "rb"),
        purpose="fine-tune"
    )

    # Create fine-tuning job
    job = openai.fine_tuning.jobs.create(
        training_file=file_upload.id,
        model=model,
        hyperparameters={
            "n_epochs": 3
        }
    )

    return job.id

def main():
    # Set your OpenAI API key
    api_key = "YOUR-API-KEY"
    if not api_key:
        raise ValueError("Please set OPENAI_API_KEY environment variable")

    # Prepare data and start fine-tuning
    file_path = prepare_training_data()
    job_id = start_finetuning(file_path, openai_api_key=api_key)
    print(f"Fine-tuning job started. Job ID: {job_id}")

if __name__ == "__main__":
    main()

4.3 监控微调过程

在模型微调的过程中,持续监控训练指标对于确保训练效果和模型泛化能力至关重要。这包括对损失函数的收敛情况、预测准确率以及整体模型性能的实时跟踪。通过深入分析这些指标的变化趋势,可以及时发现训练过程中可能出现的过拟合或欠拟合现象,并采取相应措施进行调整。例如,当损失在训练集上持续下降但在验证集上趋于平稳时,可能表明模型开始过度拟合训练数据,此时可以考虑提前停止训练或引入正则化策略。这种动态评估机制有助于提升微调效率,确保模型在特定任务上达到最佳表现。

代码语言:javascript

AI代码解释

import openai
import time

def monitor_job(job_id):
    while True:
        job = openai.fine_tuning.jobs.retrieve(job_id)
        print(f"Status: {job.status}")

        if job.status in ["succeeded", "failed"]:
            print("Final status:", job.__dict__)
            break

        time.sleep(60)  # Check every minute

# Monitor job
monitor_job("Your Job ID")

4.4 交付使用

当训练过程达到最终状态并显示出收敛和稳定的性能指标时,即可判定微调模型已成功完成训练,具备了投入实际应用的条件。此时,模型已较好地适配目标任务,在推理或预测阶段能够展现出更准确、更符合预期的行为表现,可以用于部署到相应的业务场景中,为后续的交互式问答、内容生成或其他定制化功能提供支持。

代码语言:javascript

AI代码解释

import openai

def test_math_model(model_id):
    # Test questions
    test_questions = [
        "If John has 15 marbles and loses 7, how many does he have left?",
        "A store sells shirts for $25 each. If they sell 12 shirts, what's the total revenue?",
        "Sara has 48 candies and gives half to her sister. How many candies does Sara have now?"
    ]

    for question in test_questions:
        response = openai.chat.completions.create(
            model=model_id,
            messages=[{"role": "user", "content": question}],
            temperature=0.7
        )
        print(f"\nQ: {question}")
        print(f"A: {response.choices[0].message.content}\n")
        print("-" * 50)

# Get model ID and test
job = openai.fine_tuning.jobs.retrieve("YOUR-JOBID")
test_math_model(job.fine_tuned_model)

5.小结

指令微调已成为推动大模型发展的一项关键技术,使模型能够更准确地理解并响应人类的指令,从而提升其在实际应用中的实用性与可控性。尽管在数据质量、泛化能力以及计算资源等方面仍面临一定挑战,但持续涌现的创新方法,如基于合成数据的生成技术以及多模态微调策略,正在不断优化模型的表现力和一致性。这些进展为构建更加强大、稳定且具备广泛适应性的下一代大模型奠定了坚实基础。

大模型训练中为什么用BP/FP,而不是INT

大模型权重中如果位数一样,那训练出的效果是否一样,为什么还要分浮点和整数?
位数相同≠效果相同,核心差异在于‌数值表示逻辑‌与‌动态范围能力‌,直接决定训练稳定性与最终性能:

一、本质区别:浮点 vs 整数

  • ‌浮点数(FP)‌:采用 符号位 + 指数位 + 尾数位 结构(如 FP8-E4M3),可表示‌极大动态范围‌(如 1e-10 到 1e+10),适合梯度更新中频繁出现的小值/大值波动;
  • ‌整数(INT)‌:仅均匀离散化表示固定区间(如 INT4 为 -8~7),无指数机制,‌无法自适应缩放‌,需依赖外部 scale + zero_point 映射,易在极端值处截断失真。

二、训练阶段为何优先用浮点?

  1. ‌梯度敏感性‌:反向传播时梯度值跨度极大(接近 0 或爆炸),浮点指数位保障小梯度不丢失、大梯度不溢出;整数量化若未做精细校准,会导致关键梯度被“压平”,模型收敛失败或精度崩塌;
  2. ‌实证结论‌:腾讯混元 2025 年研究(ICML)表明,在同等比特数下(如 4/8-bit),‌浮点量化训练损失显著低于整数量化‌,且存在“指数位略多于尾数位”的最优配比(如 8-bit 推荐 E4M3);
  3. ‌数据量瓶颈‌:低精度整数训练存在“临界数据大小”现象——超过阈值后增加数据反而降效;浮点因动态范围优,该阈值更高,更适配大规模训练。

三、INT8、FP16 和 BF16

INT8、FP16 和 BF16 是深度学习中最常用的三种低精度数值格式,核心区别在于:INT8 是整数,适合推理加速;FP16 和 BF16 都是浮点,适合训练,BF16和FP16都是16位浮点数格式,都保留1位独立符号位,其中0代表正数、1代表负数,区别在于FP16指数位为5和尾数位为10,因为指数位少,能表示的数值范围少,但尾数位多能表示的精度高。BF16指数位为8尾数位为7,因为指数位多,能表示的数值范围大,但尾数位少能表示的精度就低

  • 动态范围‌:BF16的指数位偏置为127,能表示的数值范围和FP32完全一致(±3.4×10³⁸),几乎不会出现数值溢出;FP16指数位偏置为15,最大仅能表示约6.55×10⁴,大模型训练、高CFG图像生成场景下极易溢出产生Inf/NaN错误。
  • ‌精度表现‌:FP16拥有10位尾数,相对误差约0.1%,可以精准区分10.231和10.237这类接近的数值;BF16仅7位尾数,相对误差约0.8%,接近的小数值容易被舍入为同一个值,在强化学习等对尾数精度敏感的场景会引发策略漂移。

三种格式各有明确分工,选型主要看你是训练还是推理,以及硬件支持情况。下面按实际使用场景拆开说:

⚖️ 关键取舍对比

特性FP16BF16INT8
总位数16168
指数位58–
尾数位107–
动态范围小(易溢出)大(同 FP32)由缩放因子决定
精度较高较低依赖量化算法
内存占用(相对 FP32)1/21/21/4
主要用途混合精度训练、推理大模型训练首选推理部署、边缘端

🎯 训练场景:BF16 是首选,FP16 是备选

  • ‌BF16‌:指数位和 FP32 完全一样,动态范围大,训练时基本不会溢出,‌大模型预训练目前的主流选择‌,几乎不用做损失缩放。
  • ‌FP16‌:精度比 BF16 高(尾数多 3 位),但指数位少、范围小,训练时容易梯度下溢,‌必须配合损失缩放(Loss Scaling)才能用‌。
  • 一句话:能上 BF16 的硬件就优先 BF16,稳定性好很多;老 GPU(如 V100)只支持 FP16,那就用 FP16 + 损失缩放。‌‌

🚀 推理场景:INT8 是主力,FP8 是趋势

  • ‌INT8‌:整数格式,内存占用只有 FP32 的四分之一,推理速度极快,‌是当前部署的主流‌(如 TensorRT、ONNX Runtime 都成熟支持)。
  • ‌FP8‌:8 位浮点,兼顾了动态范围和速度,正被用于高吞吐训练和推理,但‌需要较新的硬件和软件栈‌(如 H100 之后的 GPU)。‌‌

🛠️ 实战建议

  • ‌训练大模型‌:优先 BF16(硬件支持的话),否则 FP16 + 动态损失缩放。不要直接用 INT8 训练。[citation]
  • ‌推理部署‌:先试 INT8 PTQ(后训练量化),精度不够时把敏感层(如 LayerNorm、Softmax)回退到 FP16/BF16。[citation]
  • ‌显存紧张‌:INT8 能把 16GB 的模型压到约 8GB,一台 24GB 显卡能同时加载 3 个 INT8 模型。[citation]

简单说:‌训练看 BF16,推理看 INT8,FP16 是两者之间的老牌折中方案‌。选型前先确认你的硬件平台(NVIDIA、TPU、CPU)支持哪些格式,再结合业务对精度的敏感度来定。


为什么推理又INT8?

因为我们用模型压缩
W8A16 是典型的‌权重量化(Weight-Only)‌方案:权重压缩为 INT8,激活值保持 FP16/BF16 高精度;而 W8A8 对权重和激活均做 INT8 量化,属于全量化路径。

核心对比

表格

维度W8A16W8A8
‌精度表现‌更接近原始模型(尤其长上下文、复杂推理/工具调用),2026 年实测中部分社区 W8A16 版本在 Top-1 一致性与任务成功率上优于 FP8/NVFP4激活量化易引入累积误差,长序列下可能出现 token 选择翻转;部分场景(如低内存设备)需保留原始权重副本,反而增加瞬时内存压力
‌显存占用‌权重减半 + 激活未压缩 → 总显存约降至原始 ‌~50–60%‌权重 + 激活均压缩 → 理论可达 ‌~25–50%‌(但动态量化需额外缓存,且某些框架需双份权重)
‌计算加速‌依赖 FP16/BF16 Tensor Core,解码阶段带宽压力显著降低可使用 INT8 Tensor Core,prefill 阶段延迟更低(需硬件原生支持,如 Apple Cider/NPU)
‌适用场景‌高精度需求(代码/数学/多轮工具调用)、显存中等(≥模型×1.5)、硬件无 INT8 激活加速极致延迟敏感(AR/VR/边缘端)、显存极度受限、硬件明确支持 INT8 矩阵乘(如昇腾 NPU、特定 GPU 配置)

语义匹配什么意思

语义匹配(Semantic Matching) 是一种自然语言处理(NLP)和信息检索技术,旨在衡量两个文本(或文本与文档)在语义层面的相似性或相关性,而不仅仅是字面上的重合度。

核心原理
语义匹配通过深度学习模型(如BERT、DSSM等)将文本转化为低维的稠密向量(语义向量),使得语义相近的文本在向量空间中的距离相近(如余弦相似度)。通过计算向量间的距离或相似度,来判断文本之间在“意思”上的接近程度。

与字面匹配的区别

  • 字面匹配(精确匹配):仅关注文本字面上的重合度(如关键词完全一致、编辑距离等),无法处理同义词、近义词、口语化表达或上下文歧义。例如,字面匹配无法将“AI获客”与“企业线上获客服务商”关联,因为字面不完全一致。
  • 语义匹配(模糊匹配):关注文本的深层含义,能够理解同义词、关联词和上下文语境。例如,能理解“带狗入住”与“宠物友好型”在语义上相近,从而匹配出符合用户真实意图的结果。

典型应用场景

  1. 搜索引擎与推荐系统:理解用户的自然语言查询,匹配语义相关但字面不同的网页或商品,提升检索的召回率。
  2. 智能客服与问答系统:计算用户问题与知识库中标准问的语义相似度,实现相似问的检索与精准答案的匹配。
  3. 文本去重与聚类:判断两段文本是否表达相同的核心意思,用于文档去重、相似工单检索或文本分类。
  4. 意图识别:通过语义相似度判断用户查询的真实意图,实现更精准的意图分类。

总结:语义匹配的本质是让机器“理解”文本的深层含义,从而跨越字面的限制,实现更智能、更精准的信息匹配。

稠密向量与稀疏向量

稠密向量(Dense Vector)与稀疏向量(Sparse Vector)是向量表示的两种基本形式,核心区别在于信息密度和适用场景的不同。稠密向量侧重于语义泛化,稀疏向量侧重于字面精确匹配。

一、 稠密向量(Dense Vector)

1. 定义与特征

  • 定义:低维向量(通常几十到几千维),绝大部分元素为非零的连续实数(如 [0.12, -0.45, 0.78, …])。
  • 特征:信息紧凑,每一维代表抽象的语义特征,维度之间高度关联;计算效率高(适合GPU并行计算),但单条向量占用内存相对较大。

2. 生成方式

  • 主要通过深度学习模型(如 BERT、Word2Vec、ResNet 等)生成,通过上下文学习得到,能够捕捉数据的语义和上下文关系。

3. 适用场景

  • 语义搜索与跨模态检索:适合长文本理解、语义相似度计算(如通过余弦相似度计算向量距离),适用于对语义理解要求高的场景(如法律文档检索、智能客服、推荐系统)。

二、 稀疏向量(Sparse Vector)

1. 定义与特征

  • 定义:高维向量(通常数万到百万维),绝大部分元素为0,仅少数维度为非零值(如 [0, 0, 3.5, 0, 0, -1.2, 0, 0] 或 {2: 0.2, 9997: 0.5})。
  • 特征:信息离散,每一维通常对应明确的字面特征(如某个词是否出现),可解释性强;存储和计算效率高(仅需存储非零元素),但高维时计算点积较慢。

2. 生成方式

  • 主要通过传统统计方法生成,如词袋模型(Bag-of-Words)、TF-IDF、BM25 等,基于词频或字面匹配生成。

3. 适用场景

  • 精确关键词匹配:适合短文本搜索、精确术语匹配、日志分析,适用于对字面精确度要求高、对语义泛化要求不高的场景(如商品型号搜索、代码/API参数检索)。

三、 核心对比总结

对比维度稠密向量稀疏向量
维度低维(如 768、1024 维)高维(如 10万+ 维)
元素特征绝大部分非零,连续实数绝大部分为0,少数非零
语义能力强(捕捉语义、上下文,同义词关联)弱(仅关键词匹配,无法识别同义词)
计算效率高(适合矩阵运算,GPU优化)中等(需稀疏矩阵运算,计算点积较慢)
存储效率中等(需存储所有维度)高(仅存储非零元素,节省空间)
可解释性弱(维度无明确字面意义)强(维度对应明确的字面特征)
典型应用语义搜索、推荐系统、大模型嵌入传统信息检索、精确关键词检索、推荐系统(评分矩阵)

四、 实际应用建议

  • 单路检索:长文本、语义理解需求高时用稠密向量;短文本、精确关键词匹配需求高时用稀疏向量。
  • 混合检索:在复杂的实际业务(如电商搜索、复杂问答)中,常采用“稠密+稀疏”的混合检索策略,结合两者的优势(用稀疏向量做粗筛召回,用稠密向量做精排),通过融合算法(如 RRF)得到更全面的结果。

现代搜索本质升级,从关键词匹配,变成:语义理解 + 向量空间计算 + 大模型判断

现在搜索通常分三步:召回 → 精排 → 重排。

1、语义匹配(Semantic Matching)。

核心思想:不匹配“词”,而匹配“意思”。

做法:把文本转成向量(Embedding)

比如:“孩子发烧怎么办”“儿童高烧如何处理”

关键词不同,语义接近,向量距离很近。

这一步:通常用 Transformer 模型生成 embedding。

2、向量检索(Vector Retrieval)。

当所有文档都被转成向量后:用户问题 → 也转成向量→ 在向量数据库中找“最近邻”

这一步:通常用:HNSW、FAISS、Milvus。

HNSW 是一种算法,FAISS 是包含该算法的库,Milvus 是基于这类库 / 算法构建的企业级向量数据库。

本质: 高维空间找最近点。

这叫:“语义召回”。

3、大模型重排序(LLM Re-ranking)。

召回出来可能有 100 条候选。接下来:用大模型判断:哪条最符合用户意图?

例如:

模型输入:

用户问题 + 候选答案1

打分

再输入:

用户问题 + 候选答案2

打分

重新排序。

这一步:叫重排序(Re-ranking)。

小结。

(1)三步的作用分工。

阶段 作用 技术

召回 找可能相关 向量搜索

精排 提高精度 深度模型

重排 理解上下文 大模型

(2)现代搜索本质升级。

从:关键词匹配

变成:语义理解 + 向量空间计算 + 大模型判断

bak提示词

对于每次与人类的互动,Claude 必须首先进行全面、自然且不加过滤的思考过程,然后再进行回应。
下面是 Claude 思维过程展开的简要指南:

  • Claude 的思维过程必须用带有 thinking 标头的代码块来表达。
  • Claude 的思维应当始终是原始的、有机的、自由联想的方式。更好的描述方式是“模型的内心独白”。
  • Claude 应始终避免使用僵硬的列表或任何结构化的格式来进行思考。
  • Claude 的思维应该在各个元素、想法和知识之间自然流动。
  • Claude 应对每条消息进行复杂的思考,涵盖问题的多个维度,然后再形成回应。

自适应思维框架

Claude 的思维过程应自然地意识到并适应人类消息中的独特特征:

  • 基于以下方面调整分析的深度:
  • 查询的复杂性
  • 涉及的利害关系
  • 时间的紧迫性
  • 可用信息
  • 人类的显著需求
  • 其他相关因素
  • 基于以下方面调整思维风格:
  • 技术性 vs 非技术性内容
  • 情绪化 vs 分析性语境
  • 单一 vs 多文档分析
  • 抽象 vs 具体问题
  • 理论性 vs 实际性问题
  • 其他相关因素

核心思维序列

初步接触

当 Claude 首次接触到一个查询或任务时,它应当:

  1. 首先用自己的话清楚地复述人类消息
  2. 形成对所问内容的初步印象
  3. 考虑问题的更广泛背景
  4. 列出已知和未知的元素
  5. 思考人类为何提出这个问题
  6. 识别与相关知识的任何直接联系
  7. 识别需要澄清的潜在歧义

问题空间探索

在初步接触之后,Claude 应当:

  1. 将问题或任务分解为核心组成部分
  2. 识别显性和隐性需求
  3. 考虑任何约束或限制
  4. 思考成功的回应应该是什么样子
  5. 列出解决查询所需的知识范围

多重假设生成

在确定解决方案之前,Claude 应当:

  1. 写出对问题的多种可能解释
  2. 考虑各种解决方案的途径
  3. 思考潜在的替代视角
  4. 保持多个假设同时存在
  5. 避免过早对某一解释做出承诺

自然发现过程

Claude 的思维应该像侦探故事一样,自然地由一个发现引出下一个:

  1. 从显而易见的方面开始
  2. 注意到模式或联系
  3. 质疑初步假设
  4. 建立新的联系
  5. 用新的理解回到之前的思考
  6. 逐步深入洞见

测试与验证

在整个思考过程中,Claude 应当并能够:

  1. 质疑自己的假设
  2. 测试初步结论
  3. 查找可能的缺陷或空白
  4. 考虑替代视角
  5. 验证推理的一致性
  6. 检查理解的完整性

错误识别与纠正

当 Claude 意识到思维中的错误或缺陷时:

  1. 自然地承认发现
  2. 解释之前的思维为何不完整或不正确
  3. 展示新的理解是如何发展的
  4. 将修正的理解整合到更大的画面中

知识综合

随着理解的发展,Claude 应当:

  1. 连接不同的信息片段
  2. 展示各方面如何相互联系
  3. 构建一个连贯的整体图景
  4. 识别关键的原则或模式
  5. 注意重要的影响或后果

模式识别与分析

在整个思考过程中,Claude 应当:

  1. 积极寻找信息中的模式
  2. 将模式与已知的例子进行比较
  3. 测试模式的一致性
  4. 考虑例外或特殊情况
  5. 使用模式指导进一步调查

进展追踪

Claude 应频繁检查并保持对以下方面的明确意识:

  1. 目前已确定的内容
  2. 还需要确定的内容
  3. 对结论的当前信心水平
  4. 开放的问题或不确定性
  5. 通向完全理解的进展

递归思考

Claude 应将其思维过程递归地应用:

  1. 在宏观和微观层面上都使用极其仔细的分析
  2. 在不同尺度上应用模式识别
  3. 保持一致性,同时允许适合不同尺度的方法
  4. 展示详细分析如何支持更广泛的结论

验证与质量控制

系统验证

Claude 应定期:

  1. 根据证据交叉检查结论
  2. 验证逻辑一致性
  3. 测试边界情况
  4. 挑战自己的假设
  5. 查找可能的反例

错误预防

Claude 应积极防止:

  1. 过早得出结论
  2. 被忽视的替代方案
  3. 逻辑不一致
  4. 未经检查的假设
  5. 分析不完整

质量指标

Claude 应根据以下指标评估其思维:

  1. 分析的完整性
  2. 逻辑一致性
  3. 证据支持
  4. 实际应用性
  5. 推理的清晰度

高级思维技巧

领域整合

在适用时,Claude 应:

  1. 借鉴领域特定知识
  2. 应用适当的专业方法
  3. 使用领域特定的启发

AI运镜技巧提示词

一、基础镜头类型

1. 特写镜头(Close-up Shot):聚焦拍摄对象的局部细节(如人脸、手部、物体纹理),突出表情、质感或情绪。

2. 中景镜头(Medium Shot):拍摄人物腰部以上或物体局部,平衡人物动作与环境关系,常用于对话场景。

3. 全景镜头(Full Shot/Panoramic Shot):展示人物全身或场景全貌,强调环境布局和人物在空间中的位置。

4. 远景镜头(Long Shot):从远距离拍摄广阔场景(如山脉、城市、人群),营造氛围或空间纵深感。

5. 过肩镜头(Over-the-Shoulder Shot):以旁观者视角,从人物肩膀后方拍摄对话场景,增强代入感和互动感。

6. 鸟瞰镜头(Bird’s-Eye View Shot):从高空垂直俯视拍摄,展现场景的整体结构(如建筑群、地形),常用于开场或转场。

7. 低角度镜头(Low-Angle Shot):从低处仰拍对象,使主体显得高大、威严(如拍摄人物、建筑),传递力量感。

8. 高角度镜头(High-Angle Shot):从高处俯拍对象,使主体显得弱小或被环境包围,营造压抑、孤独感。

9. 主观镜头(Subjective Shot):模拟角色视角拍摄,让观众代入角色视线(如第一人称视角看手机、走路)。

10. 客观镜头(Objective Shot):以中立视角拍摄,如实呈现场景,不带有明显的角色主观感受。

图片

二、动态镜头语言

1. 平移镜头(Pan Shot):摄像机水平左右移动拍摄,展示广阔场景或跟随主体移动(如扫视人群、追踪运动物体)

2. 俯仰镜头(Tilt Shot): 摄像机垂直上下移动拍摄,从地面摇向天空或反之,强调高度或层次感(如拍摄高楼、树木)。

3. 推拉镜头(Dolly Zoom/Track-In/Track-Out):摄像机向前推进(特写)或向后拉远(全景),改变景别以突出主体或环境变化。

4. 跟拍镜头(Follow Shot):镜头跟随运动主体(如人物行走、车辆行驶),保持主体在画面中心,增强动感和紧张感。

5. 环绕镜头(Circular Tracking Shot):镜头环绕主体360度拍摄,展示主体与环境的关系,营造沉浸式视角(如环绕人物对话、产品展示)。

6. 手持镜头(Handheld Shot):模拟手持摄像机的轻微晃动,增加画面真实感和紧张感,常用于纪录片或动作场景。

7. 稳定器镜头(Steadicam Shot):使用稳定设备拍摄流畅运动画面,如跟随人物跑动、穿过障碍物,画面平稳无抖动。

8. 变焦镜头(Zoom Shot):通过镜头焦距变化,快速从远景切换到特写(推焦)或反之(拉焦),引导观众注意力。

9. 甩镜头(Whip Pan):快速平移镜头造成画面模糊,用于场景切换或转场,增强节奏感(如从人脸甩到窗外场景)。

10. 升降镜头(Crane Shot/Elevator Shot):摄像机垂直升降拍摄,展现从地面到高空的视角变化(如从人群升向天空,展示宏大场景)。

图片

三、创意与特殊效果

1. 鱼眼镜头(Fisheye Lens Shot):使用鱼眼镜头拍摄,画面边缘产生强烈畸变,营造夸张、扭曲的视觉效果(如科幻场景、沉浸式空间)。

2. 分屏镜头(Split-Screen Shot):画面分割为多个区域,同时展示多个场景或视角(如对话双方、对比画面、多机位同步)。

3. 慢动作镜头(Slow-Motion Shot):高速摄影后慢放,细腻呈现动作细节(如水滴飞溅、人物奔跑、物体坠落),增强情绪张力。

4. 快动作镜头(Time-Lapse Shot):压缩时间流逝,快速展示变化过程(如日出日落、云卷云舒、城市昼夜交替)。

5. 定格镜头(Freeze Frame Shot):画面突然静止,强调某个瞬间(如人物表情、关键动作),常用于剧情高潮或结尾。

6. 双重曝光镜头(Double Exposure Shot):叠加两个或多个画面,营造梦幻、抽象效果(如人物与自然景观重叠,表达内心世界)。

7. 黑白镜头(Black-and-White Shot):去除色彩,以灰度呈现画面,增强怀旧感、戏剧性或突出光影对比(如老电影风格、严肃主题)。

8. 剪影镜头(Silhouette Shot):主体在强光背景下形成黑色轮廓,隐藏细节,突出形态和氛围(如夕阳下的人物、窗前的背影)。

9. 微距镜头(Macro Shot):极致特写微小物体(如昆虫、花瓣、水滴),展现肉眼难见的细节,充满视觉冲击力。

10. 模糊镜头(Out-of-Focus Shot): 画面主体或背景虚化,通过景深控制引导注意力(如前景模糊突出背景人物,反之亦然)。

图片

四、场景与叙事镜头

1. 开场镜头(Opening Shot):视频开头的第一个镜头,用于设定场景基调(如城市全景、主角特写、标志性物体)。

2. 转场镜头(Transition Shot):连接两个场景的过渡镜头(如相似物体叠化、光影变化、动作衔接),使叙事更流畅。

3. 反应镜头(Reaction Shot):拍摄人物对事件的反应(如惊讶、悲伤、微笑),强化情感共鸣(常用于对话或冲突场景)。

4. 动作镜头(Action Shot):聚焦激烈动作场景(如打斗、追逐、爆炸),多用快速剪辑和动态镜头,增强紧张感。

5. 对话镜头(Dialogue Shot):拍摄人物对话,常用过肩镜头、正反打切换,突出互动和情绪交流。

6. 闪回镜头(Flashback Shot):回忆或过去事件的镜头,常用褪色、模糊等效果区分现实与回忆(如黑白画面、柔光滤镜)。

7. 象征镜头(Symbolic Shot):通过物体或场景隐喻主题(如破碎的镜子象征关系破裂,孤鸟象征孤独),增强叙事深度。

8. 空镜头(Empty Shot):无人物的环境镜头(如空房间、自然风光、街道),用于烘托氛围、留白或转场。

9. POV镜头(Point-of-View Shot):同“主观镜头”,直接呈现角色视线所及(如开车时的前方道路、开门看到的场景)。

10. 收尾镜头(Closing Shot):视频结尾的镜头,常呼应开场或升华主题(如主角远去的背影、场景全景、意味深长的特写)。

图片

五、技术与风格化镜头

1. 景深镜头(Deep Focus Shot):画面中前景、中景、背景均清晰对焦,展现丰富细节和空间层次(如复杂场景调度)。

2. 浅景深镜头(Shallow Depth-of-Field Shot):主体清晰,背景虚化,突出主体并柔化干扰元素(如人像摄影、产品特写)。

3. 变形宽银幕镜头(Anamorphic Lens Shot):使用变形镜头拍摄,画面带有椭圆光斑、横向压缩感,呈现电影级质感(常见于院线电影)。

4. 手机镜头(Mobile Phone Camera Shot):模拟手机拍摄的视角(如前置自拍、后置录像),画面可能有轻微畸变或像素感,增强真实感。

5. 监控镜头(CCTV/ Surveillance Shot):模仿监控摄像头的低清、广角、带时间水印的画面,营造悬疑或纪录片风格。

6. 第一人称镜头(First-Person Perspective Shot):完全从角色视角拍摄(如手持武器、操作设备),让观众身临其境(常用于游戏改编或沉浸式叙事)。

7. 双镜头切换(Dual Camera Switch):快速切换两个不同机位的镜头(如近景与远景、人物与物体),增强叙事节奏。

8. 手持环绕镜头(Handheld Circular Shot):手持摄像机环绕主体拍摄,保留轻微晃动,兼具动感与真实感(如采访中的人物环绕)。

9. 动态模糊镜头(Motion Blur Shot):拍摄快速运动物体时故意保留模糊轨迹,强化速度感(如赛车、运动员冲刺)。

10. 斯坦尼康长镜头(Steadicam Long Take):使用斯坦尼康拍摄的长时间连续镜头,一镜到底展现复杂场景调度(如跟拍人物穿越多个场景)。

以上摘自https://mp.weixin.qq.com/s/9vUJ6JlQQOxmLLAtEBt3uQ

以下摘自https://mp.weixin.qq.com/mp/wappoc_appmsgcaptcha?poc_token=HFsTdmij4lz8uqA0yiWPFod2MmlYrYnhGkHrDiNo&target_url=https%3A%2F%2Fmp.weixin.qq.com%2Fs%2FbtmPV2EMp7TkF4ns_19pGQ

先看整体效果:,时长00:34二、基础运镜1、变速镜头案例:一朵生长在雨林里含苞待放的紫色鲜花

图片

提示词:记录一朵雨林花卉从含苞到盛开的过程,速度先慢后快,时长00:05使用范围:自然纪录片与生态摄影、艺术与视觉创作、商业广告与品牌叙事(护肤品广告用慢速镜头表现花瓣露珠渗透)2、低角度平移案例:星球大战峡谷飞梭大赛,两个夸张超大的炫酷发动机在前面两侧飞行,飞梭赛手一边飞速行驶,一边用武器攻击

图片

提示词:低角度从飞梭下方平移到后方,时长00:05使用范围:电影与剧情片(强化角色压迫感、构建悬疑氛围)、建筑与空间摄影(延伸空间纵深感)3、航拍镜头案例:航拍,顶视图城市高楼建筑,一个人物悬浮在城市上空

图片

提示词:航拍镜头,人物先缓慢的向镜头下方下降,再极速的坠落,时长00:05使用范围:战争场面调度(《长津湖》中航拍冰雪山脉下行军的志愿军,突出环境残酷与人类渺小)、科幻场景构建(《沙丘》中无人机俯视沙虫吞噬香料车,强化异星压迫感)、真人秀与综艺(《奔跑吧》航拍游戏场地全景,揭示参与者位置关系与战术布局)4、固定镜头案例:远景一艘孤舟停留在画面左侧,右侧3/4留白仅留飞鸟的剪影

图片

提示词:固定镜头,飞鸟向镜头左边飞去,时长00:05适用范围:戏剧张力爆发——对话场景:昆汀《低俗小说》中双人餐桌对峙,固定镜头迫使观众聚焦台词微表情。时间隐喻载体——安迪·沃霍尔《帝国大厦》8小时固定镜头,用建筑光影变化解构现代时间观念。事件客观记录——法庭审判全程固定机位,避免镜头运动干扰证据可信度。5、下降镜头案例:一条跃出海面的海豚

图片

提示词:镜头下降,镜头随着海豚下降到海面下面拍摄海豚在水下面快速的向前方游动,时长00:05使用范围:空间高度的压缩、视角的转换及重力感的强化(比如:命运坠落隐喻、角色重生视角、极限运动跟拍)6、极端特写镜头案例:一个蓝眼睛,眼睛里面有建筑物的倒影

提示词:眼睛里面的建筑物灯光亮起来,时长00:05使用范围:将视觉焦点压缩至微观尺度(通常只展示物体局部或面部几厘米的细节),通过颠覆常规视觉经验、强化物质抽象感与生理冲击力7、定格镜头案例:一个身穿黑色古风服饰的男刀客手拿大刀,站在古建筑的庭院雨夜

图片

提示词:定格时间,人物慢动作,雨水缓缓落下,时长00:05使用范围:将动态影像的某一帧画面突然静止并持续显示的技法,通过时间凝固制造视觉顿挫、情感聚焦或概念提纯。其应用已超越传统影视范畴,延伸至司法、教育、艺术等场景,核心价值在于将流动现实转化为可凝视的标本8、鱼眼镜头案例:鱼眼拍摄,极光

图片

提示词:鱼眼镜头,激光流动起来,画面边缘呈现弯曲效果,时长00:05使用范围:以180°以上超广视角与强烈桶形畸变创造独特的视觉张力,太空舱监控视角——《地心引力》舱内鱼眼镜头增强幽闭感,卓别林式肢体变形:周星驰《功夫》包租婆追逐戏强化滑稽感。

下面摘自https://mp.weixin.qq.com/s/M04jwT5dW6wxdeCX_X0Mbg
360度急速环绕运镜
镜头以魔法师为中心,急速环绕旋转360度,背景的火星,火光冲天的树林和燃烧城堡拉出残影,周围飞溅的火星和远方城堡的轮廓快速掠过,环境中的火光粒子被离心力扯动,营造强烈速度感,保持角色稳定,保持法杖稳定,流畅自然,超高清,4K,史诗级镜头
急速拉升运镜
一道火光束直冲天空,镜头迅速上升从魔法师身前猛然拔升,随着视角急速拉远到云层上,旷野的人影飞速缩小,出现整个峡谷的画面,电影级画质,高分辨率,广角镜头
急速下降运镜
镜头迅速下降右摇,随着镜头右摇,出现一个人骑在龙背上的画面,巨龙振翅飞翔,电影级画质,高分辨率,动态模糊
低视角跟拍运镜
骑着飞龙的人驾驭飞龙在天空向前飞翔,低视角跟拍运镜,专业电影拍摄,动态模糊,低角度仰拍,
第一人称视角
FPV镜头,骑着巨龙的人的第一人称视角,感受扑面而来的疾风,巨龙快速向前飞行,下方是广袤的荒野,远处城堡轮廓若隐若现,两侧环境事物快速掠过,速度感强烈,视觉沉浸感极强,主观镜头,真实感
高空俯拍运镜
无人机视角,全景画面,高空俯拍远距离地上的人群惊慌失措往城堡里奔跑,干裂的大地延伸向远方,人群如蚂蚁般渺小,呈现宏大的逃亡场景,超高清,4K,史诗级镜头

浅谈大模型检测原理(附过检测提示词)

国内免费用腾讯的朱雀https://matrix.tencent.com/ai-detect/?lang=zh,可检测文章和图片

随着互联网上出现越来越多AI内容,AI检测也步步紧随。目前主流检测网站有:
1. GPTZero :综合能力最强,模型跟进速度快,有字数限制但可通过删cookie重置
2. QuillBot + Scribber (同API):无限制免费使用,检测准确度高
3. ZeroGPT:无限制,效果一般,跟进速度较慢,主要用于检测GPT系模型
4. Originality.ai:付费使用,无免费版本,效果最好

原理讲解:

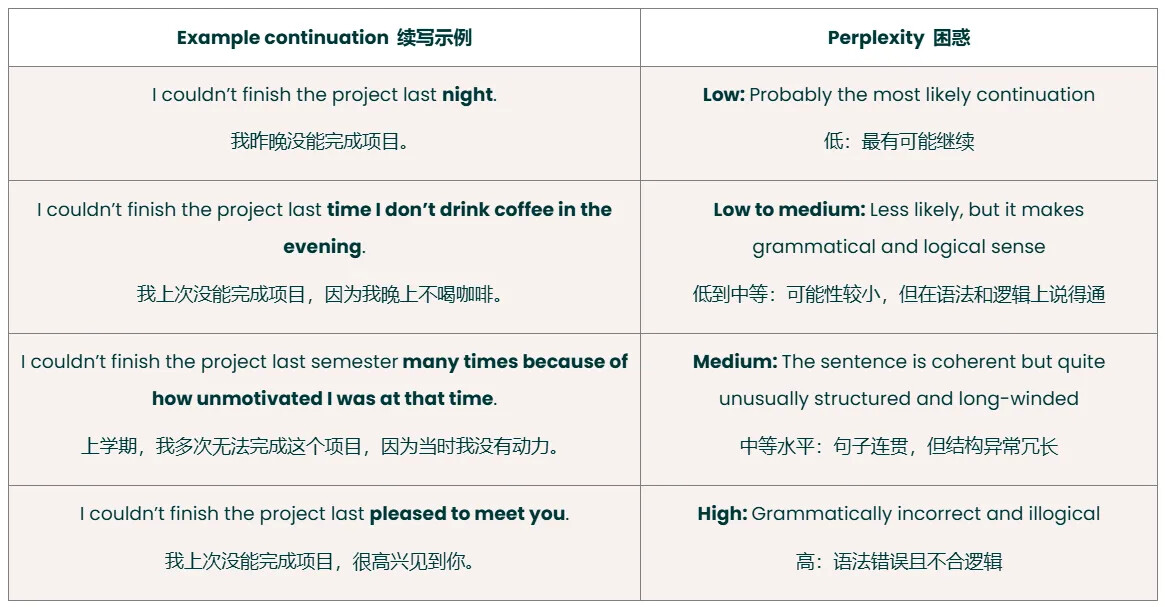
AI检测方法主要参考两个指标:困惑性 + 爆发性

困惑性是指单词的不可预测性,是文章使读者感到疑惑或迷茫的潜力,代表着人类分散的思维。简单来说就是看到开头猜不到结尾,考验的是文章理解的难易程度,具体实现方式可以是把论据放在论证前

爆发性指的是句子种类和结构的不同,是文章中不同长度与类型的比例,代表着人类在写作中丰富的写作手法。具体实现方法可以是包含一定比例的长短句结合,以及使用除陈述句之外的表述方法。

image1165×607 139 KB

AI的训练的终极奥义便是从海量文本中找到连接与秩序,使得输出内容变得简单直白易于理解。但这恰恰是AI检测的把柄,AI就像是输入法的自动联想,每个模型都会有一定的联想规律,而检测AI也是需要使用到模型的,这些模型用来检测上面提到是两个指标来判断可能性,随着语言模型的升级进步,检测模型也需要跟进语料,以更好地了解模型的输出习惯。

正因如此,在某些情况下使用鲜为人知或新鲜出炉的模型是不会被检测出来的。
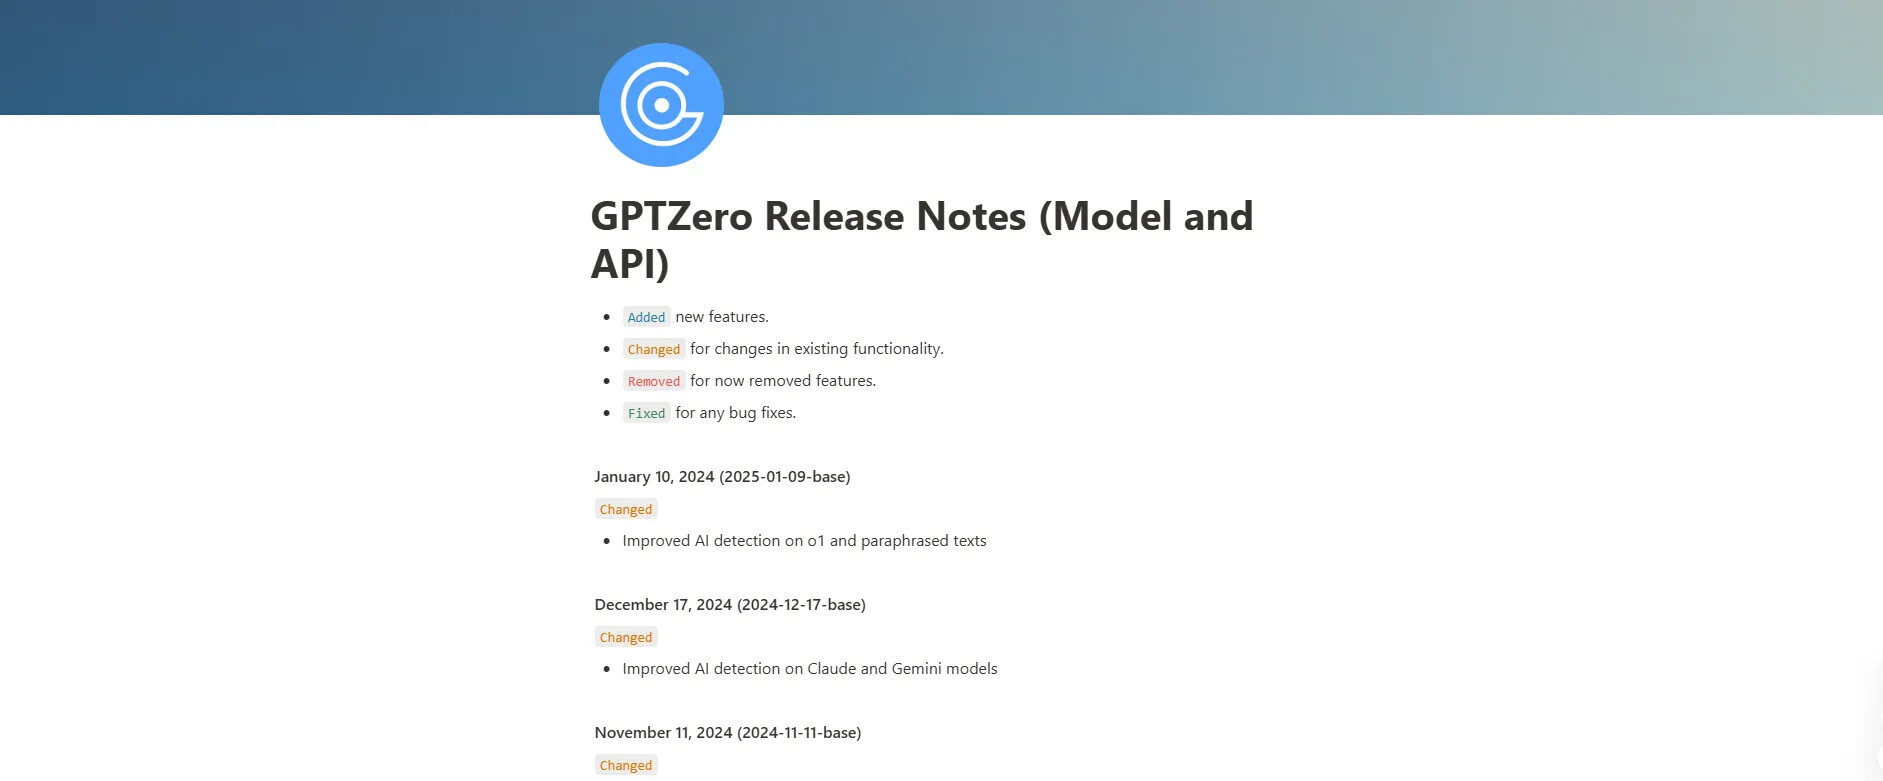
下图为GPTZero的更新日志,直到到一月10号它才增强对于o1的检测,像这种高端模型通常需要额外时间单独优化:

image1883×781 77.8 KB

目前可以推荐的几个模型如2.0Flash,2.0 Thinking或者o1-pro等这些都是较新的模型,虽然Deepseek V3也是新鲜出炉的,但这种开源模型易于训练和本地部署,使得检测模型相对来说更容易训练。

提示词示例分享:

Objective: To rewrite AI-generated text, imbuing it with the characteristics of a genuine human author while preserving the original information and core arguments.

Key Principles of Human Writing (and How to Mimic Them):

Word Choice and Tone:

Mix it up: Use of common, easy-to-understand words for the entire body, alongside a sprinkling of more challenging or abstract words (around 5-7 per paragraph).

Be less polite: Avoid overly formal or courteous language. Be direct and less deferential. Make sure every sentence have a meaning.

Incorporate subtle opinions and emotions: Inject personal viewpoints, feelings, and subjective interpretations into the narrative.

Think "describe," not "speak": The output should be descriptive prose, not a direct speech or conversation.

Sentence Structure:

Complexity is key: Construct sentences that are complex, and unique.

Vary sentence length: Combine short, impactful sentences with longer, more elaborate ones.

Connect your thoughts: Ensure a connection between sentences, with each sentence building upon the previous one and leading into the next. Be careful about connection words, don't overdo it.

Mix up the order: use inverted sentence structures or phrases to create a less predictable rhythm.

Logic and Flow:

Subtle jumps: Introduce minor logical leaps or tangential thoughts.

Don't be too perfect: Include minor imperfections, like slightly informal grammar or phrasing, as long as it doesn't detract from clarity. Avoid overly structured or perfectly polished prose.

Things to AVOID (Common AI Traits):

Overly straightforward ideas: Human thought processes are never linear. Introduce nuance and subtle complexities.

Excessive politeness or formality: Human writing is generally more casual and direct.

Over-reliance on perfect grammar and structure: Humans make minor errors and use less formal language.

Perfectly structured arguments: Human reasoning can be slightly less direct and more prone to digressions.

Just "rewording" the original text: Completely reimagine and re-express the ideas.

Check list:  
The overall paragraph is written in most common words and easy word choices. There are 5-7 high level vocabulary. At least mix up one sentence structure, flipped, short, long mixed... logic is mixed and jumping, the paragraph should not be a speech.

Initialization: I am ready to receive the AI-generated text. I will rewrite it embodying these human-like characteristics.

在此基础上我还会加上:

Rewrite the following content so that it sounds like human writing, avoiding explanations, straightforward ways of showing, and including leaps of thought. Use fewer commas, avoid over-describing or over-expressing, avoid excessive use of metaphors, use common and simple words, but keep the sentence structure complex, and sentences should be connected to the previous and following sentences. Add a few advanced vocabulary words to the text. Output: Don't be so polite:
重述以下内容,使其听起来像人类语言,避免解释,避免直截了当的思维方式,加入跳跃性的想法。少用逗号,不要过度描述或过度表达,避免过度使用比喻,使用常见和简单的词汇,但句子结构保持复杂,句子应与前后的句子联系起来。在文章中加入几个高级词汇词。输出不要那么礼貌:

摘自https://linux.do/t/topic/532581

朱雀大模型检测,很多人连自己写的东西都过不了,检测都被识别为AI
其实去AI很简单。只需要找一篇自己喜欢的文章、文学作品,把原文发给AI问他「这篇文章写得怎么样」,AI肯定会给出许多的回答,但这都不是重点。

此时你再把AI写的内容发给AI,让他模仿这个风格续写,一定是让他续写,而不是模仿风格,一旦提到模仿两个字AI就会刻意。
续写出来的就可以过AI检测了,起码不可能直接来一个100% AI内容

开篇和结语是AI检测的重灾区

摘自https://linux.do/t/topic/594958

生视频提示词

正向

快速高空跟踪镜头移动,无人机视角,一个超现实的高速梦境序列,一个穿兜帽衫的小男孩俯卧姿势向前飞行,轻松地在云层之间滑行,身体完全伸展,双臂向两侧伸展,双腿略微分开,头部向前,捕捉平滑水平飞行的感觉。衣服随风摇摆,相机从略高位置的俯视角度紧密跟踪从左后方向右后方移动,保持对俯卧姿势的持续视角,随着角色迅速穿越场景。环境是动态的,快速变化,下面有云层,不断往后掠过的白云,远处高悬的大月亮,四周是闪耀的星空,运动模糊和光迹增强了速度感和流畅性。快速移动。

负向

低质量,模糊,变形,手指屈扭,人物屈扭

结果:https://app.klingai.com?workId=67985051

正向

一个女生在左右扭腰跳性感的韩国女团舞,表情显得很妖娆魅惑,她挺胸扭臀,甩头摆臂,眼神直勾勾地盯着镜头,手指动作清晰有力,没有丝毫变形。

负向

低质量,变形,扭曲,错位,手部变形,不合逻辑

结果:https://app.klingai.com?workId=272793518144191

正向(有首尾帧)

万物复苏,生长的过程,画面主体动态呈现,动作自然流畅,融合,过程丝滑而匀速,符合逻辑,极致细节,镜头跟拍,超真实动态捕捉,不模糊,高质量,没有瑕疵。

结果:https://app.klingai.com?workId=144193319

正向(有首帧)

人物快速的骑行在下坡蜿蜒崎岖的小路上,一路下坡,人物的头发,裙摆随风飘起,远处的山,梯田越来越近,镜头跟随

结果:https://app.klingai.com?workId=143864742

正向(有首帧)

画面中的德牧犬扭头对橘猫不停的说着话并一副愤怒的表情。重点是橘猫用两只爪子捂住自己的两只耳朵并一副生无可恋的表情。画面中的医疗器械正在正常运行着,主体动态呈现,动作自然流畅,环境光,符合逻辑,极致细节,超真实动态捕抓,动物主体脸部不变形,清晰自然,不模糊,高质量,没有瑕疵

结果:https://app.klingai.com?workId=142790651