向量检索中的 HNSW(分层可导航小世界图)

HNSW(分层可导航小世界图)是一种能把亿级向量搜索时间从秒级压到毫秒级的算法‌,由 Malkov 和 Yashunin 于 2016 年提出,目前已成为 RAG 系统和向量数据库中最主流的索引技术 。它通过构建多层图结构,让检索过程像“坐电梯”一样先大步跨越再精细定位,在保证 95% 以上召回率的同时,将查询复杂度从线性降低到对数级别 。‌‌‌

它是怎么做到秒搜的(原理与优势)

  1. ‌分层导航结构‌:HNSW 把数据点组织成多层图,顶层节点少但连接距离远(像高速公路),底层节点密但连接距离近(像街道小巷)。搜索时从顶层开始,快速跳到目标附近,再逐层下降精确查找,避免了逐个比对 。‌‌‌
  2. ‌小世界特性‌:基于“六度分隔”理论,图中任意两个向量之间只需经过很少的跳转就能到达,保证搜索不会陷入死角 。‌‌‌
  3. ‌核心优势‌:
    • ‌速度极快‌:千万级向量库查询耗时仅需 1~10 毫秒,比暴力搜索快几百倍 。
    • ‌支持动态更新‌:新增数据可以直接插入图中,无需像 IVF 那样重新聚类建索引 。
    • ‌精度高‌:合理调参下召回率可稳定在 95% 以上,接近暴力搜索的精度 。
    • ‌代价‌:相比其他算法,HNSW 需要更高的内存开销来维护图结构 。‌‌‌

现在都在哪儿用它(应用与最新进展)

  1. ‌向量数据库标配‌:主流数据库如 Milvus、Weaviate、pgvector 均将 HNSW 作为默认或推荐索引类型 。例如在 Supabase 中,可直接通过 CREATE INDEX ... USING hnsw 命令开启 。
  2. ‌RAG 系统加速‌:在检索增强生成(RAG)应用中,HNSW 负责从海量知识库中快速找出与大模型问题最相关的文档片段,常与关键词搜索结合使用以提升准确性 。
  3. ‌端侧硬件加速‌:2026 年 8 月的最新进展显示,为了在手机上运行本地 AI Agent,芯片厂商开始将 HNSW 的关键路径进行 NPU 硬化加速,解决传统 CPU 处理图遍历时缓存命中率低、功耗高的问题,让隐私数据能安全留在本地设备 。‌‌‌

元数据过滤

元数据过滤是啥?

元数据本质上是“关于数据的数据”。它提供描述主要数据的附加上下文或属性,实现更精确的搜索和检索。如文档管理系统中,元数据可能包含文档的名称、作者、创建日期等。这些结构化信息使系统能够根据特定条件筛选结果,从而提高检索内容的相关性。

数据集Alpaca格式和ShareGPT格式

在我们使用和构建数据集的时候,经常会碰到两种格式的数据,分别是Alpaca格式和ShareGPT格式,今天就来介绍一下它们的共同点和不同点。

1、典型数据

首先来看一下Alpaca格式的典型数据:

[{
	"instruction": "将下面句子翻译成英语",
	"input": "我叫张三",
	"output": "My name is San Zhang"
}, {
	"instruction": "将下面句子翻译成英语",
	"input": "我叫李四",
	"output": "My name is Si Li"
}]

然后是ShareGPT格式的典型数据

[{
	"messages": [{
			"role": "user",
			"content": "3加2等于多少,只说数字"
		},
		{
			"role": "assistant",
			"content": "5"
		}
	]
}]

instruction、input、output 是 Alpaca 格式指令微调数据集的三个核心字段,用来让模型学会“看懂指令并给出对应回答”。‌‌

具体来说:

  • ‌instruction(必填)‌:告诉模型要完成什么任务,比如“列出三种交通工具”“解释什么是机器学习”。
  • ‌input(选填)‌:任务需要的辅助信息或上下文。如果指令本身已经说清楚了,这项可以留空字符串 ""。
  • ‌output(必填)‌:模型应该给出的标准回答,也就是“参考答案”。‌‌

数据一般存成 JSON 或 JSONL 文件,每行就是一条样本,例如:

json{"instruction":"列出三种交通工具。","input":"","output":"汽车、火车、飞机。"}
{"instruction":"总结下面这句话的主要观点。","input":"人工智能正在快速发展。","output":"人工智能发展迅速。"}

两种常见格式怎么选

  • ‌Alpaca 格式‌:就是 instruction/input/output,适合单轮问答、任务型指令,也是新手入门首选。
  • ‌ShareGPT 格式‌:用 conversations 列表记录多轮对话(human 和 gpt 轮流发言),适合训练聊天、客服这类多轮对话模型。‌‌

新手做数据集的小建议

‌字段必须是纯文本‌:如果 input 或 output 里出现了数组、字典这类嵌套结构,训练时会报错,需要先转成 JSON 字符串再喂给模型。‌‌

‌先跑通再扩量‌:50–100 条就够验证格式和训练流程没问题;想看到明显效果一般要 500–1000 条;3000 条以上效果才比较稳定。

‌别把知识全塞进微调‌:知识类内容适合用 RAG,微调更适合练回答格式、分析逻辑和风格。

揭开指令微调的神秘面纱

大模型指令微调作用

关于指令微调的作用描述:

  • 指令微调,在于预训练基座大模型并未针对对话或遵循指令进行优化。大模型不会回答提示:它们只是在提示后附加文本。指令微调有助于使生成的附加文本更有用。
  • 指令微调是一种专门的微调技术,通过在大量包含指令和相应响应的数据集上训练模型,使其能够更好地理解和执行用户的指令。这种方法不仅提高了模型对指令的理解能力,还增强了其生成符合预期的高质量响应的能力。
  • 通过指令微调,可以弥合LLM的下一个单词预测目标与LLM遵守人类指令的用户目标之间的差距。通过在指令数据集上微调LLM,可以使其更加符合用户需求,提高其可控性和可预测性。

我们举一个列例子,可以想象:

如果没有微调,基础大模型可能会对 “教我如何游泳” 的提示回复 “去专业的游泳馆”。

这在语法上是一种合理的完成句子的方式,但显然不能满足用户的需求,用户的初始用意应该是让大模型输出游泳的姿势动作以及如何掌控等,以帮助其学会怎么游泳。

就像之前开玩笑说会出现大量的提示语工程师(Prompt Engineer),提示语工程其实就是在做任务的微调(无参数更新),以便模型输出的结果更可能满足业务所需。

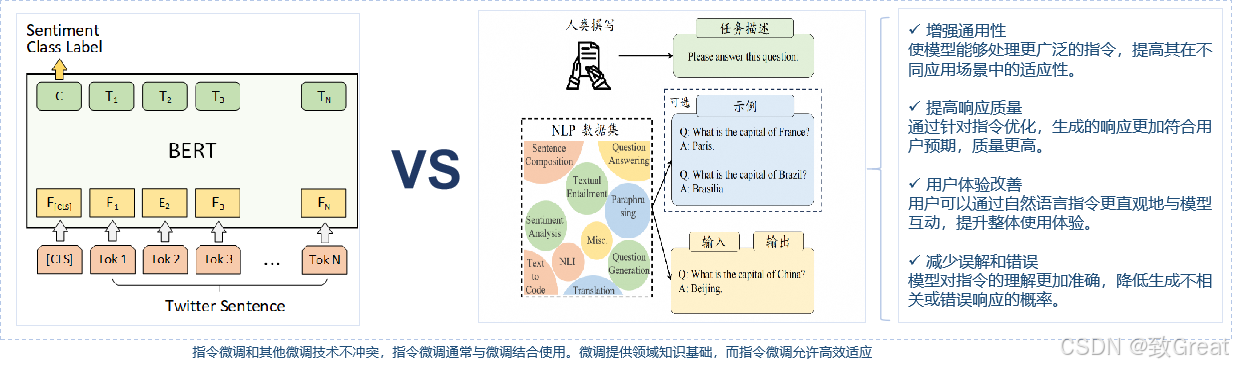
大模型指令微调与传统微调对比

指令微调通过给予模型明确的指令和反馈,为使模型专门化提供了一种替代方法,与微调只是提供输入输出示例不同,指令微调能够利用自然语言和对话,解释期望的行为和评估标准。

  • 目标不同:
    • 传统微调:通常针对特定任务(如情感分析、机器翻译)或特定领域(如医学、法律)进行优化。
    • 指令微调:旨在提升模型对各种通用指令的理解和执行能力,使其能够处理多样化的指令需求。
  • 数据类型:
    • 传统微调:使用专门针对某一任务或领域的数据集。
    • 指令微调:使用包含各种指令及其理想响应的数据集,覆盖广泛的任务和应用场景。

指令微调和其他微调技术不冲突,指令微调通常与微调结合使用。微调提供领域知识基础,而指令微调允许高效适应

指令微调需要在标记的(输入、输出)对上进行有监督学习。指令微调与其他形式的有监督微调(SFT)的区别在于:

输出展示了对这些请求的理想响应


从 GPT 这样的模型开始,大语言模型领域近年来取得了显著的进展。然而,即使这些模型变得越来越强大,它们在回答用户查询时的准确性也往往达不到预期。为了解决这个问题,人们已经开发了各种各样的策略,例如提示工程、RAG和系统提示等,这里讨论另一个重要的手段—— 指令微调。

指令数据集中的输入样本完全由类似于用户在提示中可能提出的请求的任务组成;

1. 为什么要进行指令微调?

大模型的训练方式与其在实际应用中的期望表现之间存在显著差异,这是进行指令调优的核心原因。

训练目标:LLM 通常通过预测大规模文本语料中的下一个词来学习语言模式,其核心是语言建模任务。 用户目标:用户则希望模型能够准确理解并遵循指令,以清晰、有条理且安全的方式回答问题或完成任务。

例如,如果一个模型仅被训练用于预测下一个词,当用户提问“植物是如何生长的?”时,它可能生成相关但零散的信息。而用户真正期望的是结构化、易于理解的解释。

指令调优正是为弥合这一差距而设计——使模型更好地理解和响应用户的实际需求,从而提升其实用性与可用性。

如果您对大模型的应用更感兴趣的话, 可以参考潘淳等老师的书——

2. 什么是指令微调?

指令调优是对已经预训练的大模型在特定数据集上进行进一步训练的过程,该数据集由成对的“指令—响应”组成,旨在帮助模型更好地理解并响应用户的指令。这类数据集的作用是弥合模型原本基于词汇预测的语言建模目标与用户实际使用场景之间的差距,使模型输出更贴近人类期望的内容。通常,这些指令类似于人们在真实场景中会提出的查询,例如“用简单的术语解释光合作用”,而对应的响应则是结构清晰、内容准确的回答,如“光合作用是植物将阳光转化为能量的过程”。通过这种方式,指令调优提升了模型对用户意图的理解能力。

这一方法带来了多个显著优势。首先,它提高了模型输出与用户需求之间的对齐程度,使其在面对具体问题时更加响应迅速且准确;其次,经过调优的模型在执行任务时行为更具一致性,表现出更强的可控性和可预测性;此外,指令调优还具有较高的效率,能够在不改变原有模型架构或进行大规模再训练的前提下,快速适配新的应用场景和领域需求。

然而,指令调优也面临一些挑战。高质量的指令—响应对的生成成本较高,往往需要大量人工参与以确保内容的准确性与多样性;同时,如果训练数据覆盖范围有限,模型可能只在特定任务上表现良好,难以泛化到未见过的新任务;更值得注意的是,部分模型可能仅学会了模仿响应格式等表面特征,而未能真正理解任务背后的语义逻辑,这限制了其在复杂场景中的应用潜力。

3.如何实现指令微调?

3.1 构建指令数据集

构建指令数据集是提升大模型理解和响应特定指令能力的关键步骤。这一过程主要通过两种方法实现:数据集成与合成生成。数据集成涉及将来自不同来源的带注释自然语言数据组合在一起,例如利用现有的问答数据集来创建指令-响应对。这种方法的一个实例是从已有的QA数据集中提取问题和答案,如使用“什么是重力?”作为指令,并配以相应的解释性回答:“重力是一种将物体相互吸引的力。” 这种方式不仅能够丰富指令数据集的内容,还能确保其包含广泛的主题和应用场景。

另一种方法是合成生成,即借助LLM根据少量种子数据自动生成指令及其对应的响应。比如,可以先提供一些基础指令示例,像“描述牛顿定律”,然后让模型基于这些示例生成更多类似的指令-响应对。这种方式的优势在于能够快速扩展指令数据集,同时保持一定的多样性和创新性。此外,指令还可以来源于手动收集的数据,这包括从实际应用中直接获取的真实用户查询,以及通过使用LLM从小规模种子数据开始逐步扩展而来的指令集合。无论采用哪种方法,目标都是创建一个既全面又精确反映用户需求的高质量指令数据集,为后续的指令调优奠定坚实的基础。

3.2 微调模型

在构建好高质量的指令数据集之后,下一步是对大模型进行有监督的微调。这一过程通常以指令作为输入,并训练模型逐个 token 地预测期望的输出响应,从而使其更好地理解和执行用户的请求。根据所使用的数据来源和生成方式,指令数据可分为人工创建和合成生成两大类。

人工数据通常是手工编写或从互联网中直接收集而来,虽然规模相对较小,但质量较高、针对性强,能够有效反映真实用户的需求。例如,Natural Instructions Dataset 是一个广泛使用的指令集合,涵盖了多种任务类型;P3 提供了跨语言的公共提示池,适用于多语种场景;FLAN 2021 和 LIMA 等数据集也在指令调优领域发挥了重要作用。

另一种常见的方法是通过“蒸馏”技术生成合成数据。蒸馏是一种将知识从一个强大但复杂的“教师模型”转移到更轻量、高效的“学生模型”的过程。这种方式不仅降低了数据生成的成本和时间,还能提升模型在特定任务上的表现和泛化能力。典型的合成数据集包括 AlpacaDataCleaned、WizardLM、Orca-2–13b 和 Baize 等,它们为模型训练提供了丰富且多样化的样本支持。

无论是使用人工标注还是合成生成的数据,微调的目标都是让模型更加精准地理解用户意图,并在实际应用中提供更具结构化和实用性的回应。

3.3 通过自我完善合成数据

为了进一步提升模型的指令遵循能力,可以采用一种称为自我改进的方法,这种方法利用模型自身生成的输出来逐步优化其性能。自我改进的核心在于使用模型产生的结果作为反馈机制,从而不断调整和改进模型对指令的理解与执行能力。具体来说,这一过程通常从手动创建的任务作为种子数据开始,这些任务为模型提供了初步的学习材料。接着,利用这些种子数据,模型可以通过少量样本学习的方式生成新的指令,并根据任务的具体类型(如输入优先或输出优先)来产生相应的响应。为了确保生成内容的质量,在这个过程中会应用特定的规则对输出进行筛选和过滤,以剔除不符合要求的结果。

这种自我完善的策略不仅能够帮助模型在没有大量人工干预的情况下扩展其知识库,还能有效提高指令跟随的准确性和多样性。例如,SPIN 和 Instruction Back Translation 等项目展示了如何通过自动化流程生成高质量的指令-响应对,进而增强模型的表现。此外,许多著名的指令微调大型语言模型也采用了类似的自我改进方法,包括 InstructGPT、FLAN-T5、bloomz、Claude 和 GPT-4 等。这些模型通过不断地自我学习和优化,能够在各种应用场景中提供更加精确和有用的响应,满足用户的多样化需求。这种方法的成功实施证明了自我改进技术在提升模型性能方面的巨大潜力。

如果需要本地化部署,可以参考孙杰老师的书——

3.4 多模态指令调优

随着技术的进步,指令调优正逐步扩展到涵盖多模态任务的领域,这意味着大模型现在能够同时处理文本、图像以及其他类型的数据。这种扩展不仅增强了模型的应用范围,也使得它们能够更准确地理解和响应复杂的用户需求。例如,在医疗影像分析中,模型可能需要结合病历文本和X光图像来提供诊断建议;在教育领域,模型或许要处理教材文本与相关插图以生成教学内容。为了支持这类应用,研究人员开发了多种多模态数据集,这些数据集旨在训练模型理解并处理不同形式的信息。比如,MultiInstruct多指令数据集提供了丰富的跨模态指令-响应对;PMC-VQA 和 LAMM等则专注于特定领域的多模态数据整合;Vision-FLAN等项目进一步探索了视觉信息与自然语言处理的融合。

与此同时,一系列专为多模态任务设计的模型也在不断涌现,如 instruct-pix2pix 能够根据文本指令编辑图像; Instruct-BLIP 则展示了如何将视觉元素与语言指令相结合,实现更加智能的交互体验;Otter 模型则代表了在多模态理解方面的最新进展,它能够有效地处理并生成涉及多种数据类型的复杂输出。通过这些努力,多模态指令调优正在开启人工智能应用的新篇章,推动技术向着更加智能、灵活的方向发展。这一进步不仅标志着技术上的突破,也为各行各业带来了无限的可能性。

如果您对多模态数据分析感兴趣的话, 可以参考巴川老师的书——

4.指令微调实践

在这里,尝试探讨如何在一项专注于数学领域的指令型数据集上对 GPT-3.5 Turbo 进行微调,以提升其在数学问题求解与逻辑推理方面的能力。

所使用的数据集来源于 HuggingFace 平台(~/qwedsacf/grade-school-math-instructions),该数据集专为训练模型理解和解答小学水平的数学问题而设计。它不仅包含丰富的数学题目和对应的解题步骤,还采用了结构化的组织方式,使模型能够更有效地学习从问题描述到答案推导的整个过程。这种以教程为基础的学习形式有助于增强模型在实际应用场景中的推理能力与泛化表现。

4.1 将数据转换为 JSON 格式

该数据集以 Parquet 格式提供,这是一种经过优化的列式存储格式,非常适合大规模数据的高效存储与分析处理。然而,由于 GPT 模型在进行微调时需要接收 JSON 格式的输入,以便更好地支持基于文本的任务处理,因此需要将数据转换为这一格式。JSON 结构不仅能够清晰地保留指令与响应之间的对应关系,还能提升模型训练过程中对文本数据的解析效率和准确性。

代码语言:javascript

AI代码解释

import json
import pandas as pd
from datasets import load_dataset

def prepare_math_data(dataset_name="qwedsacf/grade-school-math-instructions"):
    # Load dataset from Hugging Face
    dataset = load_dataset(dataset_name)

    # Convert to fine-tuning format
    def format_example(example):
        return {
            "messages": [
                {"role": "system", "content": "You are a helpful math tutor."},
                {"role": "user", "content": example["Instruction"]},
                {"role": "assistant", "content": example["Response"]}
            ]
        }

    # Process training data
    training_data = [format_example(item) for item in dataset["train"]]

    # Save formatted data
    with open('math_training.jsonl', 'w') as f:
        for item in training_data:
            f.write(json.dumps(item) + '\n')

    # Create validation split
    df = pd.DataFrame(training_data)
    train_df = df.sample(frac=0.8, random_state=42)
    val_df = df.drop(train_df.index)

    return train_df, val_df

def analyze_data(train_df, val_df):
    total_examples = len(train_df) + len(val_df)
    avg_instruction_len = train_df['messages'].apply(
        lambda x: len(x[1]['content'])
    ).mean()
    avg_response_len = train_df['messages'].apply(
        lambda x: len(x[2]['content'])
    ).mean()

    return {
        "total_examples": total_examples,
        "training_examples": len(train_df),
        "validation_examples": len(val_df),
        "avg_instruction_len": avg_instruction_len,
        "avg_response_len": avg_response_len
    }

4.2 微调GPT-3.5 Turbo

为了提升模型在数学相关指令上的理解与响应能力,我们采用JSON格式的数据集对其进行训练。这种格式能够更有效地组织和表达结构化信息,使模型在处理基于数学的指令时,能够准确捕捉输入与输出之间的逻辑关系,从而生成更具针对性和准确性的回应。通过这种方式,模型可以更好地掌握数学问题的求解思路,并以清晰、有条理的方式呈现答案,显著增强其在教育、辅导等应用场景中的实用性与智能化水平。

代码语言:javascript

AI代码解释

import json
import openai
from datasets import load_dataset
from typing import List, Dict
import os

def prepare_training_data(dataset_name: str = "qwedsacf/grade-school-math-instructions") -> str:
    """Prepare training data in OpenAI format"""
    dataset = load_dataset(dataset_name)

    training_data = []
    for item in dataset["train"]:
        training_example = {
            "messages": [
                {"role": "system", "content": "You are a helpful math tutor."},
                {"role": "user", "content": item["INSTRUCTION"]},
                {"role": "assistant", "content": item["RESPONSE"]}
            ]
        }
        training_data.append(training_example)

    # Save to JSONL file
    output_file = "math_training.jsonl"
    with open(output_file, "w") as f:
        for item in training_data:
            f.write(json.dumps(item) + "\n")

    return output_file

def start_finetuning(
    file_path: str,
    model: str = "gpt-3.5-turbo",
    openai_api_key: str = None
) -> str:
    """Start fine-tuning job"""
    if openai_api_key:
        openai.api_key = openai_api_key

    # Upload file
    file_upload = openai.files.create(
        file=open(file_path, "rb"),
        purpose="fine-tune"
    )

    # Create fine-tuning job
    job = openai.fine_tuning.jobs.create(
        training_file=file_upload.id,
        model=model,
        hyperparameters={
            "n_epochs": 3
        }
    )

    return job.id

def main():
    # Set your OpenAI API key
    api_key = "YOUR-API-KEY"
    if not api_key:
        raise ValueError("Please set OPENAI_API_KEY environment variable")

    # Prepare data and start fine-tuning
    file_path = prepare_training_data()
    job_id = start_finetuning(file_path, openai_api_key=api_key)
    print(f"Fine-tuning job started. Job ID: {job_id}")

if __name__ == "__main__":
    main()

4.3 监控微调过程

在模型微调的过程中,持续监控训练指标对于确保训练效果和模型泛化能力至关重要。这包括对损失函数的收敛情况、预测准确率以及整体模型性能的实时跟踪。通过深入分析这些指标的变化趋势,可以及时发现训练过程中可能出现的过拟合或欠拟合现象,并采取相应措施进行调整。例如,当损失在训练集上持续下降但在验证集上趋于平稳时,可能表明模型开始过度拟合训练数据,此时可以考虑提前停止训练或引入正则化策略。这种动态评估机制有助于提升微调效率,确保模型在特定任务上达到最佳表现。

代码语言:javascript

AI代码解释

import openai
import time

def monitor_job(job_id):
    while True:
        job = openai.fine_tuning.jobs.retrieve(job_id)
        print(f"Status: {job.status}")

        if job.status in ["succeeded", "failed"]:
            print("Final status:", job.__dict__)
            break

        time.sleep(60)  # Check every minute

# Monitor job
monitor_job("Your Job ID")

4.4 交付使用

当训练过程达到最终状态并显示出收敛和稳定的性能指标时,即可判定微调模型已成功完成训练,具备了投入实际应用的条件。此时,模型已较好地适配目标任务,在推理或预测阶段能够展现出更准确、更符合预期的行为表现,可以用于部署到相应的业务场景中,为后续的交互式问答、内容生成或其他定制化功能提供支持。

代码语言:javascript

AI代码解释

import openai

def test_math_model(model_id):
    # Test questions
    test_questions = [
        "If John has 15 marbles and loses 7, how many does he have left?",
        "A store sells shirts for $25 each. If they sell 12 shirts, what's the total revenue?",
        "Sara has 48 candies and gives half to her sister. How many candies does Sara have now?"
    ]

    for question in test_questions:
        response = openai.chat.completions.create(
            model=model_id,
            messages=[{"role": "user", "content": question}],
            temperature=0.7
        )
        print(f"\nQ: {question}")
        print(f"A: {response.choices[0].message.content}\n")
        print("-" * 50)

# Get model ID and test
job = openai.fine_tuning.jobs.retrieve("YOUR-JOBID")
test_math_model(job.fine_tuned_model)

5.小结

指令微调已成为推动大模型发展的一项关键技术,使模型能够更准确地理解并响应人类的指令,从而提升其在实际应用中的实用性与可控性。尽管在数据质量、泛化能力以及计算资源等方面仍面临一定挑战,但持续涌现的创新方法,如基于合成数据的生成技术以及多模态微调策略,正在不断优化模型的表现力和一致性。这些进展为构建更加强大、稳定且具备广泛适应性的下一代大模型奠定了坚实基础。
大模型训练中为什么用BP/FP,而不是INT

大模型权重中如果位数一样,那训练出的效果是否一样,为什么还要分浮点和整数?
位数相同≠效果相同,核心差异在于‌数值表示逻辑‌与‌动态范围能力‌,直接决定训练稳定性与最终性能:

一、本质区别:浮点 vs 整数

  • ‌浮点数(FP)‌:采用 符号位 + 指数位 + 尾数位 结构(如 FP8-E4M3),可表示‌极大动态范围‌(如 1e-10 到 1e+10),适合梯度更新中频繁出现的小值/大值波动;
  • ‌整数(INT)‌:仅均匀离散化表示固定区间(如 INT4 为 -8~7),无指数机制,‌无法自适应缩放‌,需依赖外部 scale + zero_point 映射,易在极端值处截断失真。

二、训练阶段为何优先用浮点?

  1. ‌梯度敏感性‌:反向传播时梯度值跨度极大(接近 0 或爆炸),浮点指数位保障小梯度不丢失、大梯度不溢出;整数量化若未做精细校准,会导致关键梯度被“压平”,模型收敛失败或精度崩塌;
  2. ‌实证结论‌:腾讯混元 2025 年研究(ICML)表明,在同等比特数下(如 4/8-bit),‌浮点量化训练损失显著低于整数量化‌,且存在“指数位略多于尾数位”的最优配比(如 8-bit 推荐 E4M3);
  3. ‌数据量瓶颈‌:低精度整数训练存在“临界数据大小”现象——超过阈值后增加数据反而降效;浮点因动态范围优,该阈值更高,更适配大规模训练。

三、INT8、FP16 和 BF16

INT8、FP16 和 BF16 是深度学习中最常用的三种低精度数值格式,核心区别在于:INT8 是整数,适合推理加速;FP16 和 BF16 都是浮点,适合训练,BF16和FP16都是16位浮点数格式,都保留1位独立符号位,其中0代表正数、1代表负数,区别在于FP16指数位为5和尾数位为10,因为指数位少,能表示的数值范围少,但尾数位多能表示的精度高。BF16指数位为8尾数位为7,因为指数位多,能表示的数值范围大,但尾数位少能表示的精度就低

  • 动态范围‌:BF16的指数位偏置为127,能表示的数值范围和FP32完全一致(±3.4×10³⁸),几乎不会出现数值溢出;FP16指数位偏置为15,最大仅能表示约6.55×10⁴,大模型训练、高CFG图像生成场景下极易溢出产生Inf/NaN错误。
  • ‌精度表现‌:FP16拥有10位尾数,相对误差约0.1%,可以精准区分10.231和10.237这类接近的数值;BF16仅7位尾数,相对误差约0.8%,接近的小数值容易被舍入为同一个值,在强化学习等对尾数精度敏感的场景会引发策略漂移。

三种格式各有明确分工,选型主要看你是训练还是推理,以及硬件支持情况。下面按实际使用场景拆开说:

⚖️ 关键取舍对比

特性FP16BF16INT8
总位数16168
指数位58–
尾数位107–
动态范围小(易溢出)大(同 FP32)由缩放因子决定
精度较高较低依赖量化算法
内存占用(相对 FP32)1/21/21/4
主要用途混合精度训练、推理大模型训练首选推理部署、边缘端

🎯 训练场景:BF16 是首选,FP16 是备选

  • ‌BF16‌:指数位和 FP32 完全一样,动态范围大,训练时基本不会溢出,‌大模型预训练目前的主流选择‌,几乎不用做损失缩放。
  • ‌FP16‌:精度比 BF16 高(尾数多 3 位),但指数位少、范围小,训练时容易梯度下溢,‌必须配合损失缩放(Loss Scaling)才能用‌。
  • 一句话:能上 BF16 的硬件就优先 BF16,稳定性好很多;老 GPU(如 V100)只支持 FP16,那就用 FP16 + 损失缩放。‌‌

🚀 推理场景:INT8 是主力,FP8 是趋势

  • ‌INT8‌:整数格式,内存占用只有 FP32 的四分之一,推理速度极快,‌是当前部署的主流‌(如 TensorRT、ONNX Runtime 都成熟支持)。
  • ‌FP8‌:8 位浮点,兼顾了动态范围和速度,正被用于高吞吐训练和推理,但‌需要较新的硬件和软件栈‌(如 H100 之后的 GPU)。‌‌

🛠️ 实战建议

  • ‌训练大模型‌:优先 BF16(硬件支持的话),否则 FP16 + 动态损失缩放。不要直接用 INT8 训练。[citation]
  • ‌推理部署‌:先试 INT8 PTQ(后训练量化),精度不够时把敏感层(如 LayerNorm、Softmax)回退到 FP16/BF16。[citation]
  • ‌显存紧张‌:INT8 能把 16GB 的模型压到约 8GB,一台 24GB 显卡能同时加载 3 个 INT8 模型。[citation]

简单说:‌训练看 BF16,推理看 INT8,FP16 是两者之间的老牌折中方案‌。选型前先确认你的硬件平台(NVIDIA、TPU、CPU)支持哪些格式,再结合业务对精度的敏感度来定。


为什么推理又INT8?

因为我们用模型压缩
W8A16 是典型的‌权重量化(Weight-Only)‌方案:权重压缩为 INT8,激活值保持 FP16/BF16 高精度;而 W8A8 对权重和激活均做 INT8 量化,属于全量化路径。

核心对比

表格

维度W8A16W8A8
‌精度表现‌更接近原始模型(尤其长上下文、复杂推理/工具调用),2026 年实测中部分社区 W8A16 版本在 Top-1 一致性与任务成功率上优于 FP8/NVFP4激活量化易引入累积误差,长序列下可能出现 token 选择翻转;部分场景(如低内存设备)需保留原始权重副本,反而增加瞬时内存压力
‌显存占用‌权重减半 + 激活未压缩 → 总显存约降至原始 ‌~50–60%‌权重 + 激活均压缩 → 理论可达 ‌~25–50%‌(但动态量化需额外缓存,且某些框架需双份权重)
‌计算加速‌依赖 FP16/BF16 Tensor Core,解码阶段带宽压力显著降低可使用 INT8 Tensor Core,prefill 阶段延迟更低(需硬件原生支持,如 Apple Cider/NPU)
‌适用场景‌高精度需求(代码/数学/多轮工具调用)、显存中等(≥模型×1.5)、硬件无 INT8 激活加速极致延迟敏感(AR/VR/边缘端)、显存极度受限、硬件明确支持 INT8 矩阵乘(如昇腾 NPU、特定 GPU 配置)

语义匹配什么意思

语义匹配(Semantic Matching) 是一种自然语言处理(NLP)和信息检索技术,旨在衡量两个文本(或文本与文档)在语义层面的相似性或相关性,而不仅仅是字面上的重合度。

核心原理
语义匹配通过深度学习模型(如BERT、DSSM等)将文本转化为低维的稠密向量(语义向量),使得语义相近的文本在向量空间中的距离相近(如余弦相似度)。通过计算向量间的距离或相似度,来判断文本之间在“意思”上的接近程度。

与字面匹配的区别

  • 字面匹配(精确匹配):仅关注文本字面上的重合度(如关键词完全一致、编辑距离等),无法处理同义词、近义词、口语化表达或上下文歧义。例如,字面匹配无法将“AI获客”与“企业线上获客服务商”关联,因为字面不完全一致。
  • 语义匹配(模糊匹配):关注文本的深层含义,能够理解同义词、关联词和上下文语境。例如,能理解“带狗入住”与“宠物友好型”在语义上相近,从而匹配出符合用户真实意图的结果。

典型应用场景

  1. 搜索引擎与推荐系统:理解用户的自然语言查询,匹配语义相关但字面不同的网页或商品,提升检索的召回率。
  2. 智能客服与问答系统:计算用户问题与知识库中标准问的语义相似度,实现相似问的检索与精准答案的匹配。
  3. 文本去重与聚类:判断两段文本是否表达相同的核心意思,用于文档去重、相似工单检索或文本分类。
  4. 意图识别:通过语义相似度判断用户查询的真实意图,实现更精准的意图分类。

总结:语义匹配的本质是让机器“理解”文本的深层含义,从而跨越字面的限制,实现更智能、更精准的信息匹配。

稠密向量与稀疏向量

稠密向量(Dense Vector)与稀疏向量(Sparse Vector)是向量表示的两种基本形式,核心区别在于信息密度和适用场景的不同。稠密向量侧重于语义泛化,稀疏向量侧重于字面精确匹配。

一、 稠密向量(Dense Vector)

1. 定义与特征

  • 定义:低维向量(通常几十到几千维),绝大部分元素为非零的连续实数(如 [0.12, -0.45, 0.78, …])。
  • 特征:信息紧凑,每一维代表抽象的语义特征,维度之间高度关联;计算效率高(适合GPU并行计算),但单条向量占用内存相对较大。

2. 生成方式

  • 主要通过深度学习模型(如 BERT、Word2Vec、ResNet 等)生成,通过上下文学习得到,能够捕捉数据的语义和上下文关系。

3. 适用场景

  • 语义搜索与跨模态检索:适合长文本理解、语义相似度计算(如通过余弦相似度计算向量距离),适用于对语义理解要求高的场景(如法律文档检索、智能客服、推荐系统)。

二、 稀疏向量(Sparse Vector)

1. 定义与特征

  • 定义:高维向量(通常数万到百万维),绝大部分元素为0,仅少数维度为非零值(如 [0, 0, 3.5, 0, 0, -1.2, 0, 0] 或 {2: 0.2, 9997: 0.5})。
  • 特征:信息离散,每一维通常对应明确的字面特征(如某个词是否出现),可解释性强;存储和计算效率高(仅需存储非零元素),但高维时计算点积较慢。

2. 生成方式

  • 主要通过传统统计方法生成,如词袋模型(Bag-of-Words)、TF-IDF、BM25 等,基于词频或字面匹配生成。

3. 适用场景

  • 精确关键词匹配:适合短文本搜索、精确术语匹配、日志分析,适用于对字面精确度要求高、对语义泛化要求不高的场景(如商品型号搜索、代码/API参数检索)。

三、 核心对比总结

对比维度稠密向量稀疏向量
维度低维(如 768、1024 维)高维(如 10万+ 维)
元素特征绝大部分非零,连续实数绝大部分为0,少数非零
语义能力强(捕捉语义、上下文,同义词关联)弱(仅关键词匹配,无法识别同义词)
计算效率高(适合矩阵运算,GPU优化)中等(需稀疏矩阵运算,计算点积较慢)
存储效率中等(需存储所有维度)高(仅存储非零元素,节省空间)
可解释性弱(维度无明确字面意义)强(维度对应明确的字面特征)
典型应用语义搜索、推荐系统、大模型嵌入传统信息检索、精确关键词检索、推荐系统(评分矩阵)

四、 实际应用建议

  • 单路检索:长文本、语义理解需求高时用稠密向量;短文本、精确关键词匹配需求高时用稀疏向量。
  • 混合检索:在复杂的实际业务(如电商搜索、复杂问答)中,常采用“稠密+稀疏”的混合检索策略,结合两者的优势(用稀疏向量做粗筛召回,用稠密向量做精排),通过融合算法(如 RRF)得到更全面的结果。

现代搜索本质升级,从关键词匹配,变成:语义理解 + 向量空间计算 + 大模型判断

现在搜索通常分三步:召回 → 精排 → 重排。

1、语义匹配(Semantic Matching)。

核心思想:不匹配“词”,而匹配“意思”。

做法:把文本转成向量(Embedding)

比如:“孩子发烧怎么办”“儿童高烧如何处理”

关键词不同,语义接近,向量距离很近。

这一步:通常用 Transformer 模型生成 embedding。

2、向量检索(Vector Retrieval)。

当所有文档都被转成向量后:用户问题 → 也转成向量→ 在向量数据库中找“最近邻”

这一步:通常用:HNSW、FAISS、Milvus。

HNSW 是一种算法,FAISS 是包含该算法的库,Milvus 是基于这类库 / 算法构建的企业级向量数据库。

本质: 高维空间找最近点。

这叫:“语义召回”。

3、大模型重排序(LLM Re-ranking)。

召回出来可能有 100 条候选。接下来:用大模型判断:哪条最符合用户意图?

例如:

模型输入:

用户问题 + 候选答案1

打分

再输入:

用户问题 + 候选答案2

打分

重新排序。

这一步:叫重排序(Re-ranking)。

小结。

(1)三步的作用分工。

阶段 作用 技术

召回 找可能相关 向量搜索

精排 提高精度 深度模型

重排 理解上下文 大模型

(2)现代搜索本质升级。

从:关键词匹配

变成:语义理解 + 向量空间计算 + 大模型判断

CSS毛玻璃特效

取自https://glassgenerator.netlify.app/#


<div class="glass-container" id="glass"></div>


.glass-container{
    width: 700px;
    height: 375px;
    color: white;
    display: flex;
    justify-content: center;
    align-items: center;
    gap: 20px;
    border-radius: 21px;
    backdrop-filter: blur(5px);
    background-color: rgba(255,102,0, 0.181);
    box-shadow: rgba(0, 0, 0, 0.3) 2px 8px 8px;
    border: 1px rgba(255,255,255,0.4) solid;
    border-bottom: 1px rgba(40,40,40,0.35) solid;
    border-right: 1px rgba(40,40,40,0.35) solid;
}

docker-compose文件详解以及常用命令

docker-compose.yml

Docker Compose 是一个用于定义和运行多容器 Docker 应用程序的工具,它使用 YAML 文件来配置应用程序的服务、网络和卷。在一个完整的 docker-compose.yml 文件中,你可以定义多个服务,每个服务都包含了各种配置选项。以下是一个详细解释的 docker-compose.yml 文件示例,以及其中包含的各个部分:

version: '3'  # Docker Compose 文件版本

services:  # 服务定义的部分开始
  web:  # 第一个服务名称,可以自定义
    image: nginx:latest  # 使用的镜像及版本
    container_name: my_web_app  # 容器的自定义名称
    ports:  # 端口映射配置
      - "8080:80"  # 将容器内部的 80 端口映射到主机的 8080 端口
    volumes:  # 卷挂载配置
      - ./html:/usr/share/nginx/html  # 挂载本地 ./html 目录到容器的 /usr/share/nginx/html

  app:  # 第二个服务名称
    build:  # 构建镜像的配置
      context: ./app  # Dockerfile 所在目录
      dockerfile: Dockerfile.prod  # 自定义 Dockerfile 文件名
    container_name: my_app  # 容器的自定义名称
    environment:  # 环境变量配置
      - DEBUG=True  # 设置环境变量 DEBUG 为 True
    depends_on:  # 依赖关系配置
      - db  # 依赖于名为 "db" 的服务

  db:  # 第三个服务名称
    image: postgres:12  # 使用的 PostgreSQL 镜像及版本
    container_name: my_postgres_db  # 容器的自定义名称
    environment:  # 环境变量配置
      - POSTGRES_PASSWORD=secret  # 设置 PostgreSQL 密码为 "secret"
      - POSTGRES_DB=mydatabase  # 创建数据库名为 "mydatabase"

networks:  # 网络定义的部分开始
  my_network:  # 自定义网络名称
    driver: bridge  # 网络驱动程序,默认为 bridge
    ipam:  # IP 地址管理配置
      config:  # IP 配置
        - subnet: 172.28.0.0/16  # 子网配置

volumes:  # 卷定义的部分开始
  my_volume:  # 自定义卷名称
    driver: local  # 卷驱动程序,默认为 local
    driver_opts:  # 驱动程序选项配置
      type: none  # 驱动程序类型
      device: /mydata  # 卷的本地路径

这个示例包含了一个完整的 docker-compose.yml 文件,并详细解释了其中的各个部分:

  • version:指定了 Docker Compose 文件的版本。在示例中,使用的是版本 3。
  • services:这是定义各个服务的部分。每个服务都可以包含以下属性:
    • image:指定了要使用的镜像及其版本。
    • container_name:设置容器的自定义名称。
    • ports:用于将容器内部端口映射到主机上的端口。
    • volumes:用于挂载主机上的目录或卷到容器内部。
    • build:如果需要构建自定义镜像,可以使用 build 属性来指定 Dockerfile 的路径。
    • environment:设置容器内部的环境变量。
    • depends_on:定义了服务之间的依赖关系。在示例中,app 服务依赖于 db 服务。
  • networks:这是定义自定义网络的部分。可以定义多个自定义网络,并指定网络驱动程序、IP 地址管理配置等。
  • volumes:这是定义自定义卷的部分。可以定义多个自定义卷,并指定卷的驱动程序、驱动程序选项等。

这个示例中包含了一个完整的 docker-compose.yml 文件,你可以根据自己的需求自定义服务、网络和卷的配置。 Docker Compose 文件的强大之处在于它可以轻松管理复杂的多容器应用程序的部署和配置。

docker-compose常用命令

Docker Compose 提供了一组命令来管理容器应用程序的生命周期。以下是一些常用的命令及其解释:

  1. docker-compose up:启动应用程序。它会创建和启动定义在 docker-compose.yml 文件中的所有服务。
  2. docker-compose up -d:以后台模式启动应用程序,即不会在终端上显示日志输出。
  3. docker-compose down:停止并移除应用程序的所有容器、网络和卷。
  4. docker-compose ps:列出正在运行的容器。
  5. docker-compose logs:查看应用程序的日志输出。
  6. docker-compose build:构建在 docker-compose.yml 文件中定义的服务。如果你修改了 Dockerfile 或应用程序代码,需要重新构建镜像。
  7. docker-compose stop:停止运行中的应用程序,但不会移除容器。
  8. docker-compose start:启动停止的应用程序。
  9. docker-compose restart:重新启动应用程序的容器。
  10. docker-compose exec <service> <command>:在指定的服务容器内执行命令。例如,docker-compose exec app bash 可以在 app 服务容器内打开一个 Bash 终端。
  11. docker-compose down -v:停止并移除应用程序的所有容器、网络、卷以及关联的数据卷。谨慎使用,它会删除数据。
  12. docker-compose pull:拉取定义在 docker-compose.yml 文件中的所有服务所需的镜像,但不会启动容器。